要把论文像明星一样包装起来
更新记录
- · 更名 StarPaper,更新写作 skill · skill 更新
- 统一教程、博客、仓库与网址名称;新增流星标题图与夜空 ACCEPT 主图。
- 写作包新增独立 cs-limitations,按九个章节模块加载;补齐单段两点模板与 Metrics 格式。
- 区分讨论与局限性,核对贡献格式、篇幅要求和全文范围的一致性。
- · 补全历史更新记录
- 补回首次发布以来的主要更新,按时间倒序显示;无序号,下拉栏可滚动查看。
- · 精简论文绘图章节
- 正文改为 Mainfig、Framework 与实验绘图三节,每节两个模板例子。
- 融入绘图笔记、标出铁律,增加同一内容或数据的优化前后教学对照。
- 其余 18 张图移至文末“收集的参考绘图”,保留出处、许可与点评。
- · 更新评论与批注入口
- 评论、批注和页脚统计使用同一可用服务入口,保留已有评论与公开/私密设置。
- · 新增点赞与浏览统计
- 页脚显示共享点赞数与浏览次数,点赞可取消;重复请求去重,统计从启用后累计。
- · 补全写作与绘图 skill 介绍
- 网页和 README 写明技能名称、用途、源码与下载入口;补充中英文搜索摘要和仓库主题标签。
- · 同步写作与绘图 skill · skill 更新
- 补齐数字与文献版本口径、Related Work 的应用字段。
- 更新实验章首模板、有效评估范围、判分可靠性与章节承接。
- 补齐图注、脚注和移图规范;下载链接标出 latest,新增折叠更新记录。
- · 更名 BeautyPaper
- 更新西施犬展示论文、三位评委举起 ACCEPT 的主图,并同步博客封面。
- · 写作 skill 按章节拆分 · skill 更新
- 拆为入口、共享规则和六个章节;同步钩子、引言结构、贡献格式与 Related Work 收尾。
- · 区分铁律与建议 · skill 更新
- 只给必须遵守的要求标注铁律,调整正文与 skill 的规则措辞。
- · 补齐精修要求 · skill 更新
- 完善篇幅分配、各章节规范与提交前检查,同步写作 skill。
- · 增加全文组织模板
- 提供方法论文、基准与数据集论文、诊断驱动研究的章节结构与衔接方式。
- · 补全章节对应关系
- 用图展示引言如何连接方法、实验、结论和局限,补充论文大纲。
- · 集中段落批注示范
- 精修部分改为章节原则与完整段落批注,收拢零散中英例子。
- · 分开写作与绘图技能 · skill 更新
- 提供独立下载入口,更新主页主图,增加单栏 Mainfig 参考。
- · 精简教程语言 · skill 更新
- 删去重复解释和口号,统一为简洁、直接的表达,同步下载 skill。
- · 补入章节目的与写作笔记
- 说明各章如何支撑贡献,完善正文与绘图的对应指导。
- · 发布独立绘图 skill
- 增加下载与使用入口,整理绘图规范、常见错误及对应图例。
- · 说明 Overleaf 同步条件
- 补充项目 owner 的会员要求,以及本地编译和跳过同步的替代方式。
- · 完善草稿流程
- 补充材料填写、图表准备、章节组织和正文审核,并提供图表模板。
- · 支持正文批注
- 增加选文批注、公开回复侧栏与评论入口。
- · 补齐章节规范与图例 · skill 更新
- 整理全文要求、各章模板与逐图点评,并同步写作 skill。
- · 按写作流程重组教程
- 分为草稿、绘图、精修和辅助工具四部分。
- · 增加快速起草入口
- 提供可填写的 Codex 提示词,按论文顺序整理正文指导。
- · 扩充论文示例来源
- 加入多个研究方向的论文例子,完善来源说明。
- · 发布写作 skill 与铁律
- 增加 skill 下载、安装说明及写作规则。
- · 整理研究工具
- 按用途收录文献、绘图、翻译与代码阅读工具,附使用说明。
- · 补全论文示例与来源标注
- 为写作条目补充中英示例,标明出处与许可。
- · 首次公开 PaperBank
- 发布写作教程、示例、参考来源与转载使用条款。
这里有两个可以直接使用的 skill,按任务下载。 cs-paper-writing latest:【2026-10-13 00:38】 · 绘图 latest:【2026-10-13 00:38】 · 用法
写在前头
StarPaper 提供可直接用于 Codex 的论文写作 skill(cs-paper-writing)和学术绘图 skill(starpaper-figures)。写作按章节加载,绘图覆盖 mainfig、framework、案例图、统计图和 LaTeX 图表。
本指南用于学术讨论,整理本人在论文写作与修改中的经验,供研究者参考。本人并非领域权威,内容可能有误。
网页开源并支持批注。欢迎指出错误、讨论具体写法,我会根据反馈修订。
多数例子来自本人、本人参与或熟人的论文,另选少量具有参考价值的公开论文。各例均附出处;如用于研究,请引用对应原论文。
1. 初稿准备
准备研究材料与模板,确定正文结构,再进入论文绘图。图先成型,方便合作者审阅;正文随后填充。
1.1 研究材料与模板
先整理研究问题、已有局限、对应设计和真实结果,附上可核对的文献、图与数据。下载目标会议当年的官方模板,确认页数并编译。使用 Overleaf 时,将最新源文件同步到本地;Git 同步需要项目 owner 有会员或相应权限,没有则下载源文件 ZIP、本地编译,或跳过同步。写明允许修改的文件,再把材料填入提示词,让 Codex 先形成提纲和初稿。
下载写作 skill latest:【2026-10-13 00:38】 · 安装与用法
填写研究材料,生成初稿
读取 cs-paper-writing/SKILL.md:先读共享规则,只加载当前任务相关的章节 skill;不默认读全部例库。
核对目标会议及 track 的 AI 规定和材料使用权限,遵守当轮允许范围。未经许可,不向外部服务发送未公开稿件、review、个人数据或密钥。
会议、官方模板、正文页数与附录规定:【】
研究问题与已有不足:【】;真实设计与依据:【】
实验材料、指标口径、对照与真实结果:【】
结构适合的参考论文与想借鉴的部分:【】
允许修改的文件与范围:【】

1. 核对模板并编译,保留最新源、原始结果与合作者修改。
2. 先梳理参考部分的各节职责、论证顺序与输入输出衔接,再按自己的研究拟大纲。只借鉴组织,不复制措辞、事实或主张。
3. 完成关键图,确定问题、设计与证据的对应;绘图读取 cs-visuals,精修图形可另读公开绘图 skill。
4. 列章节标题、任务、证据与篇幅。Method Overview 接回具体困难并串起真实输入输出;模块开头先写动机,再写真实设计。
5. 按主张组织实验;整体结果、局部差异与独立条件分析分别给比较范围和分母。没有实际分析,不补标题或结果。
6. 引言先说明已有能力与具体不足,再逐项说明解法、机制用途和有依据的发现。段首承接具体对象,连接词服从真实逻辑。
7. 贡献用原生 itemize,固定三项:工作概述、新机制与实际用途、实验发现。第 2 项点名新设计及作用,不重复已经解释的障碍标签。
8. 先给我中文提纲和证据,再按当前授权写英文。检查真实数值、引用、图表、分页与最终 PDF;远端源和服务端 PDF 分开核验。
局限性按 cs-limitations:用一个自然段、First 和 Second 两点,让步说明有据工作与具体边界。依据:cs-writing-common · cs-abstract-introduction · cs-related-work · cs-method · cs-experiments · cs-visuals · cs-integration · cs-limitations · 对应铁律与完整提示词
1.2 正文结构
- 找一篇组织结构适合的参考论文,把想借鉴的部分交给 Codex。先让它梳理各节职责、论证顺序与章节衔接,再按自己的研究内容拟大纲;参考结构,不照搬主张或结果。
- 先列章节标题、各节要回答的问题、对应证据与篇幅。标题用具体对象或任务,不把多个无关动作塞在一节。
- 同一问题贯穿引言、相关工作、设计与实验。用 For [limitation], we [对应动作] 点名问题;结论回答原问题,局限全文一致。
- Method 的 Overview 先说设计为何处理局限,再概括后文各节的输入、输出与依赖;诊断型另交代瓶颈证据,基准型另交代系统输入与评分材料。
- 实验按主张安排:整体效果看主结果,设计作用用受控检验,能力边界看相关条件。诊断驱动研究还要复测原诊断。具体设置和写法见第 3 章实验部分。
论文大纲与章节衔接
引言没有固定的模板数量。先按主要贡献选论证主线,再排全文章节;诊断驱动的论文要先把发现讲成立,不能只换一个引言标题。下列三套供借鉴,段落数、模块数和节号按实际内容调整。
| 论文类型 | 引言的论证顺序 | 正文的展开顺序 |
|---|---|---|
| 方法论文 | 背景与回顾 → 局限 → 设计 → 发现 → 贡献总结 | Related Work → Method → Experiments → Conclusion |
| 基准与数据集论文 | 能力与评价 → 缺口及建设障碍 → 产物与设计 → 发现 → 贡献总结 | Related Work → Construction → Evaluation → Conclusion |
| 诊断驱动的改进研究 | 能力判断 → 质疑与发现 → 瓶颈 → 设计 → 验证 → 贡献总结 | Diagnostic Analysis → Method → Experiments → Related Work → Conclusion |
方法论文:大纲与章节衔接
核心贡献是一个新方法或系统设计。先说已知局限,再解释设计如何处理它,最后检验效果与设计作用。
填写方括号中的对象、动作与证据。节名和编号是示意;下图展示串行方法,实际并行或反馈应画出相应关系。
Abstract:压缩研究问题、主要贡献和关键发现;主张、术语与适用范围和引言、正文一致。通常在主要结果确定后定稿。
为什么要研究[问题]?已有路线哪里不足?本文怎样处理?实验发现什么?
- 背景与比较:先交代领域目标、已有进展与比较依据;前两段可以穿插或合并。
- 具体局限:However, [limitation] ... 说明在什么条件下,现有路线为什么达不到[目标]。
- 核心工作与设计:To address these obstacles, we introduce [name], a [亮点与用途]. 随后用 For [limitation], we [设计与作用] 逐项对应。
- 结果与贡献总结:概述已验证的主要发现,再以 In summary, our contributions are: 和贡献列表收尾。
已有局限的比较依据在哪里?
按共同任务或机制分组,说明真正相关的路线怎样工作。
- 每个主题收尾:However, [与引言一致的具体缺口]. To address this gap, we [动作] [对象] based on [真实原则]. This enables [实际应用], addressing [同一缺口]. 三句依次写缺口、做法、应用与问题解决。
哪些设计处理这些局限,为什么这样设计?
Overview:核心思想是[设计思路]。For [局限一], we [设计 A 的关键动作],产生[中间产物 a];[设计 B]用它处理[局限二]并产生[b];[执行流程]将这些设计落实为[最终输出]。按实际节名和节号介绍对应作用。
3.1 Problem Formulation · 定义任务输入、要求输出、目标与约束。训练、推理和评价各能看到哪些信息分开说明;已有定义较长时可另设 Preliminaries。
3.2 [设计 A 的具体名称]
输入 [任务输入 x]
For [局限一], [关键操作与依据].
输出 [中间产物 a]
3.3 [设计 B 的具体名称]
输入 [a] + [必要附加信息]
For [局限二], [关键操作与依据].
输出 [中间产物 b]
3.4 [训练、推理或评价流程]
输入 [b] + [执行所需材料]
说明实际优化目标、运行步骤或评分协议;按论文类型选择。
输出 [最终输出 y]
串行示意:x → A → a → B → b → 执行流程 → y。箭头传递实际对象;并非每篇论文都需要两个模块或训练过程。
怎样检验整体目标与各项设计的作用?
Overview 说明后续小节怎样组成完整方法;模块数服从实际设计。训练和推理信息不同,应分别画清楚,不能把评分参考当作模型可见输入。
按研究问题组织证据;先交代设置,再给主结果和针对性检验。
- 4.1 Experimental Setup:数据版本与划分;Metrics 的定义、方向、分母和汇总;Baselines 的来源及可比条件;Implementation 的训练/推理、调参、预算与重复设置。说明误差条或区间的含义;人工或模型评分另交代协议与核验。
- 4.2 Main Results:回答整体研究问题:实际结论 → 关键对照与图表 → 证据支持的含义及范围。
- 4.3 Design Validation(按需):围绕[设计为何处理局限]安排受控删除、替换或其他对照;说明变化因素、保留条件与耦合差异。基准论文可检验数据、判据或评分协议的有效性。
- 4.4 Further Analysis(按需):按主张选择泛化、敏感性、资源代价、错误分析或解释检验;每节回答一个具体问题。个例展示过程,频率结论仍需总体统计。
结果支持了什么,哪些解释和范围仍未得到验证?
解释发现与已有研究的关系,区分观察、可能解释和已验证机制;说明本文假设、覆盖范围、失败条件及影响。
- 按实际内容与投稿要求:讨论可与分析合并;Limitations 可独立成节。数据授权、人类参与、隐私或风险等问题在适用时说明。
在实际证据范围内,开头的问题得到什么答案?
简短回答研究问题,概括已验证的贡献与发现;保留同一证据范围,不新增结果或设计。
References 支撑已有工作、定义与外部事实。Appendix 提供完整设置、算法或提示词、补充结果与复核材料;核心主张的必要证据不能全部藏在附录。局限、伦理与其他声明的位置按投稿要求确定。
NeurIPS Paper Checklist · 实验设置、可复核性、不确定性与结论范围可对照核查;上图的节名和顺序是写作模板。
基准与数据集论文:大纲与章节衔接
核心贡献是数据、基准或评价协议。先明确评价缺口,再讲产物如何构建、怎样评分,最后分析被评价系统的表现。
核心产物是数据、基准或评价协议。先定义并构建评价对象,再报告系统表现及诊断;不要求虚构一个新模型。
Abstract:压缩研究问题、主要贡献和关键发现;主张、术语与适用范围和引言、正文一致。通常在主要结果确定后定稿。
为什么现有评价还不能回答[能力问题]?本文提供什么输入、判据或协议?
- 背景与已有评价:回顾能力和评价方式,比较同一目标、输入与判据;不把“未报告”写成“没有”。
- 评价缺口与建设障碍:先讲无法区分的[行为],再讲收集[数据]或构建[判据]为什么困难;两类问题分别接到设计。
- 产物与对应贡献:To address these obstacles, we introduce [name], a [亮点与评价用途]. For [评价局限], we [数据或判据设计].
- 测评发现与贡献总结:先概述真正有信息量的发现,再总结数据、评价设计及发现的独立贡献。
哪些相关路线支持这个比较?
按任务或评价目标归类,说明已有输入、判据和覆盖范围。
- 每个主题末尾:However, [与引言一致的具体缺口]. To address this gap, we [动作] [对象] based on [真实原则]. This enables [实际应用], addressing [同一缺口]. 三句依次写缺口、做法、应用与问题解决。
对应的缺口怎样落实为评价设计?
Overview:评价[目标能力]需要[输入与判据]。我们将[来源材料]构造成[案例],再据此定义[评价准则];受测系统生成[回复],评分者按[证据与准则]评估它。下面分别讲案例、判据与评分协议;若还提出辅助方法,另讲其作用。
3.1 Problem Formulation · 定义任务、系统输入 x、回复 y、参考证据 r 与评分目标。系统可见材料和评分者可见材料分开。
3.2 Data / Case Construction
输入 [原始来源材料]
说明来源范围、筛选或采样、标注与数据划分,产物对应前文的评价缺口。
输出 [案例 x 与参考证据 r]
3.3 Evaluation Criteria
输入 [案例 x、参考证据 r]
定义判据及制定依据;说明如何区分目标行为、可接受答案与错误。
输出 [准则 c]
3.4 Response Assessment
输入 [回复 y] + [x, r, c]
说明评分者、评分步骤、汇总和必要核验;此处定义协议,下一章执行测评。
输出 [评分与报告格式]
资料流:来源 → 案例 → 准则 → 评分协议。另一路:受测系统接收 x,生成 y;评分者结合 y、r 和 c 评分。不能让评测参考泄漏到系统输入。
用这套评价实际看到了什么,它是否测到了目标能力?
有独立的辅助方法时,在构建章内或单独设节,解释它与评价目标的关系;没有就不加。判据制定、评分执行与结果分析分清职责。
交代可比设置,概述主要发现,再解释差异、失败及评价边界。
- 4.1 Evaluation Setup:交代数据划分、受测系统、运行条件、指标、评分协议和不确定性;评分核验放在读者理解评分的位置。
- 4.2 Main Results:To answer [研究问题], we evaluate [系统]. 先给发现,再给关键比较和支持范围;不从一串模型名或分数排名开讲。
- 4.3 Evaluation Validation(按需):围绕“确实测到[目标]”安排有区分力的对照、判据或评分核验;不能只用一次总分比较证明评价有效。
- 4.4 Scenario / Error Analysis:按条件或失败模式回答具体问题;个例解释过程,频率或普遍性结论要有总体统计。
哪些结论得到支持,哪些条件仍未覆盖?
回答最初的评价问题,概括产物和主要发现;不把覆盖范围写成真实使用频率。
Limitations / Ethics Statement
说明来源与任务覆盖、判据及评分边界,按实际研究说明授权、隐私或风险。
References 支撑已有工作、定义与外部事实。Appendix 提供完整设置、算法或提示词、补充结果与复核材料;核心主张的必要证据不能全部藏在附录。局限、伦理与其他声明的位置按投稿要求确定。
诊断驱动的改进研究:大纲与章节衔接
先通过实验揭示问题、定位瓶颈,再据此提出并验证改进。诊断是独立贡献,方法和验证都要回扣它。
诊断在方法之前成立。诊断条件和观察维度会在后续验证中再次出现;只做主结果表,回答不了最初发现的问题。
Abstract:压缩研究问题、主要贡献和关键发现;主张、术语与适用范围和引言、正文一致。通常在主要结果确定后定稿。
已有成绩是否真的代表[目标能力]?诊断发现什么,瓶颈在哪里,本文怎样回应?
- 背景与能力判断:介绍已有路线及成绩,说明这些成绩通常被理解成什么能力。
- 质疑与诊断发现:However, [能力质疑]. 说明[受控诊断]如何检验它,紧接最有信息量的观察。
- 瓶颈与设计判断:进一步对照区分可能解释;说明有证据支持的[瓶颈]为何需要[设计思路]。
- 方法、验证与贡献总结:概述针对瓶颈的设计及主要验证,最后总结诊断发现、方法与验证贡献。
先把质疑变成可检验要求,再给诊断证据。
在介绍改进方法前,先证明问题存在,并给出定位瓶颈的依据。
- 2.1 Testable Hypothesis:把[目标能力]转成在[受控条件]下应该满足的可检验要求。
- 2.2 Diagnostic Data and Protocol:说明改变了哪个条件、保留了什么,如何控制相关混淆因素及比较预算。
- 2.3 Findings and Diagnostic Controls:报告目标表现与过程症状,使用有区分力的对照检验解释;不能把相关变化直接当作因果机制。
诊断指出的瓶颈,成为方法每项设计的理由。
Overview:诊断表明[瓶颈 A]妨碍[目标]。For [瓶颈 A], we [设计 A],产生[a];[设计 B]用它处理[瓶颈 B],产生[b];[训练或执行流程]把它们落实为[y]。先讲为什么这样设计,再展开输入输出与依赖。
3.1 Overview / Problem Formulation · 定义必要对象及训练、推理输入输出;已在诊断章定义的对象直接承接,不重写一遍。
3.2 [Design A]
输入 [任务输入 x]
For [诊断瓶颈 A], [设计动作与依据].
输出 [产物 a]
3.3 [Design B]
输入 [a] + [必要信息]
For [诊断瓶颈 B], [设计动作与依据].
输出 [产物 b]
3.4 [Training / Execution]
输入 [b] + [执行材料]
给出实际训练目标或执行流程;按方法选择,不强加训练步骤。
输出 [最终输出 y]
每项设计都接到诊断中的具体瓶颈;箭头交接真实对象,模块数量与关系按实际方法调整。
既要验证主任务表现,也要复测原诊断,看最初的失败是否缓解。
诊断章的假设、对照与发现要能独立读懂;方法的引出不能替代对问题本身的验证。
围绕诊断和设计安排验证;终点表现、诊断复测、过程证据各回答不同问题。
- 4.1 Experimental Setup:说明数据、基线、指标与公平比较条件;诊断章已有协议只补新增条件。
- 4.2 Main Results:回答改进方法在主要任务上是否有效,说明例外与范围。
- 4.3 Diagnostic Robustness:复用第 2 章的诊断条件,检验原有失败是否缓解及其范围。
- 4.4 Process / Mechanism Analysis:复用诊断维度,看过程变化是否符合瓶颈解释;机制主张需要有区分力的检验。
- 4.5 Ablation / Alternative Explanations:检验关键设计,按当前主张控制额外预算、提示或其他替代解释。
比较这些证据是否共同支持原来的设计判断。
围绕已明确的问题和设计比较相关路线;主题末尾用 However 说明局限,紧接本文处理方式。
- 位置选择:可像此模板放在实验后,也可放在引言后;前置时让读者先获得必要概念,后置时突出诊断主线。
回到最初的能力问题,收束诊断与验证。
回答[目标能力问题]:诊断揭示什么,设计怎样回应,证据支持到什么范围。
Limitations / Ethics Statement
局限与引言、诊断和结论一致;说明仍未解决的问题及适用范围。
References 支撑已有工作、定义与外部事实。Appendix 提供完整设置、算法或提示词、补充结果与复核材料;核心主张的必要证据不能全部藏在附录。局限、伦理与其他声明的位置按投稿要求确定。
只有实证发现、没有改进方法时:Introduction → Study Design → Results → Robustness / Further Analysis → Discussion → Conclusion。引言按“问题 → 证据缺口 → 研究设计 → 发现 → 贡献总结”组织;删去改进方法及其消融。Related Work、局限及声明的位置按论证和投稿要求调整。
引言的贡献总结:默认保留的格式
先用连贯段落讲清核心工作、设计为何对应局限,以及实验发现。方法名后的同位语立即交代亮点与用途;不要让读者读完一串流程才知道贡献。
铁律 普通正文引导句后接原生 itemize;固定三项,列表后直接下一节,不追加目录预告、链接或新结果。
铁律 普通正文引导句后接原生 itemize,固定三项:工作概述、新机制与实际用途、实验发现。第 2 项用 We propose [机制] 点名真正的新设计,说明依据、具体作用及实际应用;正文已建立问题与解法时,不再重复障碍标签。第 3 项给证据范围,新名称首次就近定义,列表后直接下一节。
三项是本套 CS 写作约定,不是所有会议的官方要求。论文类型与当轮要求优先;先删重复背景和次要流程,不用改模板规避篇幅限制。
贡献列表:LaTeX 格式
In summary, our contributions are:
\begin{itemize}
    \item We introduce [research object], which supports [task] with [verified distinguishing feature].
    \item We propose [mechanism], derived from [verified basis], which [specific function] and supports [actual application].
    \item Experiments within [tested scope] reveal [verified finding]. Further diagnosis identifies [supported recurring problems].
\end{itemize}| Method | Success (%) ↑ | Latency (ms) ↓ |
|---|---|---|
| Baseline A | 70.0±2.0 | 120±4 |
| Baseline B | 73.0±1.0 | 130±4 |
| Proposed method | 76.0±1.0 | 125±3 |
LaTeX 表格模板
% Add these packages to the preamble if the venue permits them.
\usepackage{booktabs}
\usepackage[table]{xcolor}
\definecolor{bestcell}{HTML}{F2EBEA}
\definecolor{secondcell}{HTML}{EDF0F4}

% Insert this environment in the body.
\begin{table}[!t]
\centering
\caption{Illustrative values only. Success rate is in percent;
latency is in milliseconds. Superscripts illustrate standard deviations.
Best values are bold; second-best values are underlined.}
\label{tab:main-results}
\begin{tabular}{lcc}
\toprule
Method & Success ($\uparrow$) & Latency ($\downarrow$) \\
\midrule
Baseline A & 70.0\textsuperscript{\(\pm2.0\)}
 & \cellcolor{bestcell}\textbf{120}\textsuperscript{\(\pm4\)} \\
Baseline B & \cellcolor{secondcell}\underline{73.0}\textsuperscript{\(\pm1.0\)}
 & 130\textsuperscript{\(\pm4\)} \\
Proposed method & \cellcolor{bestcell}\textbf{76.0}\textsuperscript{\(\pm1.0\)}
 & \cellcolor{secondcell}\underline{125}\textsuperscript{\(\pm3\)} \\
\bottomrule
\end{tabular}
\end{table}包声明放导言区,table 环境放正文;先确认会议模板允许这些包。正式表替换真实数据,并在表注写清统计单位、重复次数、实际可比范围及主要发现。跨栏时用 table*,不改模板栏宽。
正文结构确定后,进入论文绘图。Mainfig 让读者看懂问题与核心贡献;framework 说明设计怎样处理问题及输入输出关系;结果图支持实验发现。先确定每张图要证明什么,再画图和精修。 进入第 2 章:论文绘图 →
给 Codex 用:写作与绘图 skill
按章节加载:共享规则、摘要与引言、相关工作、方法、实验、图表、局限性、全文整合。 解压后保留九个同级目录,先读 cs-paper-writing/SKILL.md,再按任务加载。
cs-paper-writing ZIP latest:【2026-10-13 00:38】 · SKILL.md:按章节加载:共享规则、摘要与引言、相关工作、方法、实验、图表、局限性、全文整合。 解压后保留九个同级目录,先读 cs-paper-writing/SKILL.md,再按任务加载。
绘图 ZIP latest:【2026-10-13 00:38】 · SKILL.md:解压后让 Codex 读取整个 starpaper-figures/ 文件夹,并提供稿件、原始数据、参考图及允许修改的文件。
写作包已按章节拆分:入口、共享规则和六个章节,共九个同级文件夹。解压后保留全部文件夹,让 Codex 先读 cs-paper-writing/SKILL.md,再只加载当前任务相关的章节。绘图 ZIP 单独使用。填入材料、任务和允许修改的范围。
写作包更新:2026-10-13 00:38。只含通用规则与教学模板,不含私人稿件信息。
中文使用提示词
读取 cs-paper-writing/SKILL.md:先读共享规则,只加载当前任务相关的章节 skill;不默认读全部例库。
核对目标会议及 track 的 AI 规定和材料使用权限,遵守当轮允许范围。未经许可,不向外部服务发送未公开稿件、review、个人数据或密钥。
任务与论文类型:【】;目标会议及限制:【】
材料:【最新源、真实结果、原文依据】;允许修改:【】

1. 先核对具体不足、实际设计和对应证据。后句承接前句的对象、问题或产物,再增加一个判断。
2. Therefore 归纳证据,Specifically 展开判断,However 写具体转折;For example 或 For instance 放在引例句首。缺少某设计后,说清因此不能区分什么。相邻句段不反复使用同一个过渡词。
3. 对象和动作尽早出现;保留有依据的贡献信息,删除无信息叠加。清楚、就近且唯一的代词保留,符号、缩写、单位与来源就近定义。
4. 按当前章规则修改。引言不永久强制 Therefore 或 To solve;贡献第 2 项写新机制、依据、具体作用与实际用途。Related Work 按固定三句收尾,Method 按真实输入输出衔接,模块先交代动机。
5. 摘要、引言、方法、实验与结论统一问题、名称、数字、范围和因果方向。整体发现与局部诊断分开,不能用相关或条件结果冒充机制证明。
6. 不改原始记录、实验协议、冻结 prompt 或模型回复,不编结果和引用。保留人工定版及并发修改。只读任务不写文件,缺证据的问题留给作者。
7. 检查最终 PDF 的句长、图表、脚注、分页与计页。只有明确必须遵守或禁止违反的要求标“铁律”,写法建议不升级为硬规则。
数字给单位、分母与版本,区分百分比与百分点、宏平均与微平均;不以分号拼接长句。核对文献实际版本、发布日期与预印本身份。
涉及 Limitations 时加载 cs-limitations:一个自然段,用 First 和 Second 写两项有据工作与具体边界;未测不当失败,实质限制与全文结论一致。依据:cs-writing-common · cs-abstract-introduction · cs-related-work · cs-method · cs-experiments · cs-visuals · cs-integration · cs-limitations · 对应铁律与完整提示词
2. 论文绘图
先完成 Mainfig 与 Framework,人工核对贡献、流程和案例;实验图用 Python 读取真实数据。下面按三类图整理笔记、铁律和优化前后示范。
下载绘图 skill latest:【2026-10-13 00:38】 · SKILL.md
- 先选一张结构清楚的参考图,借鉴读图顺序与配色;内容、数值和贡献用自己的材料。
- 高亮越多,背景越应保持白色;同类内容同框、同层内容对齐,留白由信息关系决定。
- 铁律 按最终栏宽检查。图内字同一字号,介于正文减 2 pt 至正文,字体与正文一致;放不下就重排,不缩字、不压扁图、不改论文模板。
- 铁律 每图解释必要简称、标记与统计口径。Caption 先说明图是什么,再按面板顺序带读;插回论文检查字号、重叠、裁切与首次引用。
填写绘图任务与数据
读取 starpaper-figures/SKILL.md 和 references/rules.md。按以下材料画图。
使用前:核对目标会议及 track 的 AI 规定,只在允许范围内起草、改写或绘图,按要求披露。确认材料使用权限和工具的数据处理方式;未获许可,不向外部服务上传未公开稿件、review、个人数据或密钥。
图型:【mainfig/framework/统计图/案例图】
要突出的问题与贡献:【对应 Intro 的哪项困难,方法改了什么,依据在哪里】
材料:【稿件、真实数据、参考图与出处、已有案例及使用位置】
真实结构:【输入、操作、输出、接收者;并行、汇合、反馈;训练/推理/评价】
允许修改:【文件与范围】;最终插入宽度:【mm】
正文 PDF 实测字体与字号:【字体,pt】;本篇已确认色板:【】

铁律:
1. mainfig 讲问题、已有缺口与关键改动,默认不超过 5 个环节;framework 先让人看懂设计为什么好,再画完整输入、操作与产物。两图分别承担不同叙述任务。
2. 每条箭头对应真实依赖,不穿文字。保留并行与反馈;训练、推理、评价分开。输入、输出、评价规则用三种边框并给图例;仅供评价的信息不能画成模型输入。
3. 按最终宽度起稿。所有标题、坐标、刻度、图例、数字、注释用同一字号,正文减 2 pt ≤ 图字 ≤ 正文,字体家族匹配。放不下就重排或拆图,不缩小规定字号、不进行非等比缩放、不修改论文模板。
4. 白底、近白面板、深色文字、低饱和配色。同一对象全篇同色,用形状或线型辅助区分;不加渐变、阴影和装饰光效。通栏先参考 16:9,单栏参考 4:3,内容与可读性优先。
5. 模块名与正文一致。缩写、变量、单位、图标、颜色和线型都能解释;图标旁写对象名。标签用自然语言,不用符号拼句。
6. 同一案例全文只呈现一次,翻译、裁剪或改名仍算同一个。先按来源核对使用位置,其他位置交叉引用。对话一轮一框;作者示例与实测回复分清,没有评分不画勾。
7. 统计图用 Python 等专业工具读取所附数据,保留数值、坐标几何、分母、单位与 SD/SE/CI 定义;同类比较统一尺度。不为美观补缺测、改数据或平滑曲线,不重跑实验;KDE 等估计图说明样本量、方法和带宽。概念图按当前环境使用 imagegen,生成内容须依据已确认流程,不生成虚构结果。
8. Caption 先说明图是什么,再解释必要标记和术语,按实际面板或上下左右读序带读,最后给有证据的发现与贡献意义;简称在本条 Caption 写全称。方法图说明机制,不编实验结论。尽量三行,必要定义与事实边界优先。
9. PDF 文字可见、可选,字体嵌入;不叠两套字形或隐藏 OCR。统计图优先矢量 PDF,含位图的 PDF 不称全矢量。CS 图表默认 [!t],实际位置跟随正文首次引用,保留附录归属。
10. 先给问题、布局和缺口,再绘制。插回论文编译,看最终页面的字号、图例、裁切、碰撞和引用顺序。交付源文件、PDF、预览及实际检查结果。只改色时保留原布局、文字、连线与图片;保留他人修改,不扩大范围。
每图自身解释简称,案例条件对应难点,颜色点明对象。Caption 保留全图读法,单项判定用 \footnote 与 \footref;跨栏脚注可用 savenotes,并查落页与跳转。评分通过不写成真实执行。移图到附录同步详解、Overview 和引用;显示改名不改冻结记录。依据:paper-visual-standards · academic-plotting · clean-flow-figures · 对应铁律与完整提示词
完整绘图规范
- 每图明确一个主要任务:mainfig 展示研究动机与观察,framework 说明设计如何对应问题,结果图提供验证证据。每图明确一个主要任务。 模板 2:用一个关键观察开题 ↗
- 绘图先于正文精修:先完成可供合作者审核的框架图与实验图,再精修正文。图未能体现贡献时,先调整内容与布局,再修改配色。 训练范围对照 ↗
- 铁律 统计图使用真实数据:统计图用 Python 从真实数据绘制;imagegen 用于动机、框架和案例图。缺数据就停,不补点、不编误差、不为平滑改曲线。 模板 2:按职责分组,用案例串流程 ↗ KDE 密度分布 ↗
- 铁律 按最终尺寸检查字号:按最终栏宽排字,字体与正文一致;所有图内字同一字号,介于正文与正文减 2 pt 之间,标题也不能更大。放不下先重排,不缩小规定字号。 训练范围对照 ↗
- 铁律 箭头表示真实依赖:同层成组并命名;先后、并行、汇合、反馈按真实依赖画。每条箭头说清传什么,起止明确,避免穿过文字与无必要的迂回。 模板 2:按职责分组,用案例串流程 ↗
- 铁律 区分输入与评价信息:输入、输出、评价规则用三种边框区分,并给图例。只供评价的 rubric 不连到被测模型;不同模型收到不同材料,也要标清。 模板 2:按职责分组,用案例串流程 ↗
- 铁律 低饱和配色与清晰对比:常规模块用中性灰,关键改动用统一强调色。低饱和配色须保持清晰对比。 模板 2:多面板共用编码与图例 ↗
- 铁律 对话按轮次与语义分段:一轮一框,注明角色;同一轮长回复按语义分段,不伪装成多轮。高亮只标关键约束、证据或错误,颜色含义要能读懂。 交互案例 ↗
- 铁律 同一案例仅完整呈现一次:同一来源的案例在全文只完整呈现一次,其他位置交叉引用。改名、翻译、裁剪也算同一个;必要对照集中展示,单个案例不能证明总体效果。 交互案例 ↗
- 铁律 同类子图使用一致尺度:围绕一个问题排现象、诊断、对照和稳健性;同条件同顺序、同配色,同类轴和色标保持可比。 多面板诊断 ↗
- 铁律 准确呈现坐标与差异:查单位、分母、方向、坐标起点和误差类型;截断坐标要明确标出。相对增益同时给绝对值,柱长和数值必须对应。 配对增益 ↗
- 铁律 Caption 按图的读序讲解:先定位图表对象,在本图 Caption 或对应脚注解释实际简称,再按读序带读。案例条件对应难点标签,颜色点明连接对象;保留必要单位、分母与边界,不堆单项判定。“显著”须有统计检验。 置信区间与误差带 ↗
- 铁律 编译后检查最终页面:放回论文检查实际字号、字体嵌入、可选文字、裁切、碰撞、图注总高度和首次引用顺序。源码字号正确,不代表插入后仍正确。图表移到附录时,同步详解、Overview 与引用,正文保留主要结论。 问题与解法对照 ↗
- 铁律 明确模块输入与输出:每个关键模块写清收到什么、做什么、交出什么,以及交给谁。模块名与 Method 一致,所有缩写就近解释。 模板 2:按职责分组,用案例串流程 ↗
- 铁律 解释图中所有标记:图标旁写对象名;新缩写、符号、边框、线型和数字就近解释。读者只看图与图注,应知道每个标记指什么。 模板 2:按职责分组,用案例串流程 ↗
- 铁律 Framework 展示操作与产物:“结合 case 去绘制你的流程” 展示一个真实输入怎样变成中间产物和输出,旁边点出设计解决的困难。节点多不等于贡献多。 交互案例 ↗ 模板 2:按职责分组,用案例串流程 ↗
- 铁律 区分示意与实测:估计、作者示例和实测输出分清;可选路径不能画成必经步骤。框的面积、线宽和箭头不能暗示没有证据的比例或因果,图形本身须准确,不能仅靠图注纠正。评分通过不等于真实执行、成交或部署成功;显示改名不改冻结 prompt、机器字段和统计,不冒称执行原文。 成本与性能 ↗
- 铁律 准确区分矢量与位图:统计图导出矢量 PDF 并嵌入字体。生成底图上的标签另排原生、可见、可选的 PDF 文字;不留重叠字形,不加隐藏 OCR 层。混合 PDF 仍含位图。 训练范围对照 ↗
- 铁律 保持修改范围:只改配色就保留布局、文字、换行、字号、公式、照片和连线;重排须在约定范围内。保留数据、实验和合作者的图。 模板 2:多面板共用编码与图例 ↗
- 铁律 按模板宽度布局:按实际栏宽起稿,不改页边距、正文字号或页面方向。正文通栏约 16:9、单栏约 4:3 是起点,附录可纵排;不进行非等比缩放。CS 默认用 [!t],再按正文首次引用检查实际落点。 问题与解法对照 ↗
- 铁律 表格用于结果与数据:StarPaper 默认表格只放真实结果或数据。术语、方法、实验计划和案例点评写正文,不能通过截图规避该规则;统计数字也不能把说明表变成实验结果。 模板 2:多面板共用编码与图例 ↗
- 铁律 重排文字与图形重叠处:图例、标题、刻度和注释不能挡数据、箭头或边框。为文字保留空间,通过重排解决重叠,不能用遮盖隐藏问题。 KDE 密度分布 ↗
2.1 Mainfig
让读者先看懂为什么要做这项研究,以及本文解决了什么。
- 先简化。只留问题、关键观察和本文改动;框多不代表贡献多。
- 方法型:Baseline 与 Ours 同层对齐,问题与解决步骤一一对应;发现型:用一张实测图提出问题。
- 用位置讲关系,用少量高亮讲重点;图标旁写对象名,删掉重复背景和装饰。
- 铁律 示意和实测分清。生成工具只画概念;曲线与数值从真实数据绘制,不用示意图暗示已验证的效果。
模板 1:问题与改动对照
点击图可放大;窄屏可横向滚动。
先找要讲的缺口,再删掉不能帮助理解缺口的节点。左右保持同一问题和阅读顺序,让改动位置可直接比较。
StarPaper 原创教学改排,CC BY 4.0;非原论文修订记录。
模板 2:用一个关键观察开题
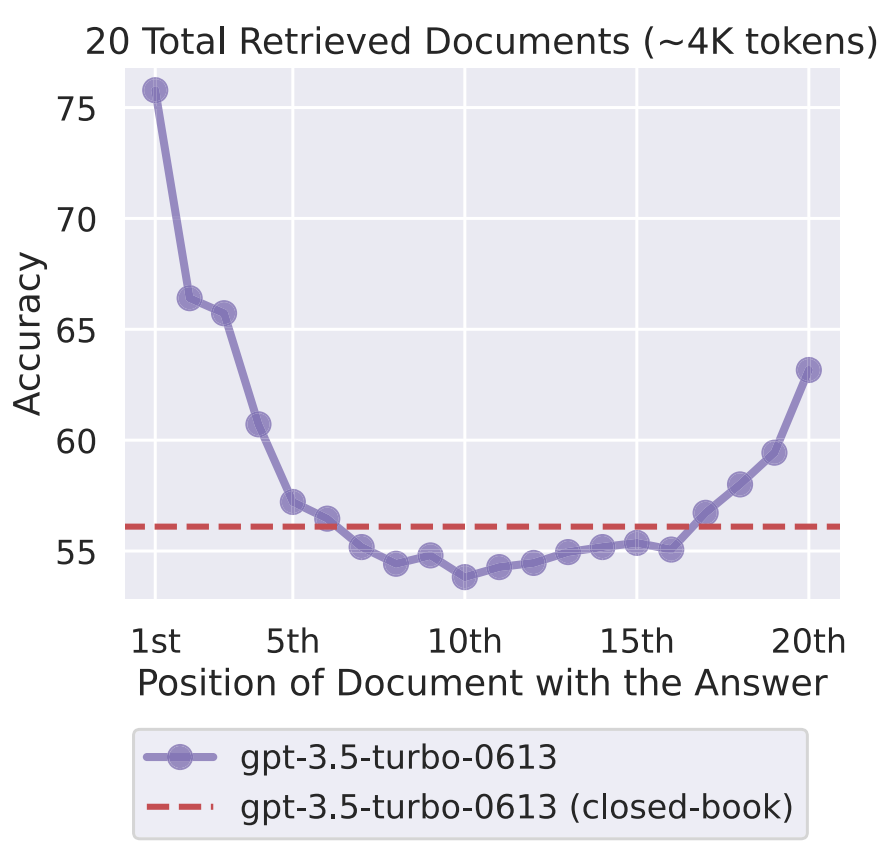
一个变量、一条结果曲线、一条基准线就能提出问题。结论限于该模型与设置;纵轴未从零开始,不能按曲线高度读倍数。
Liu et al. · Lost in the Middle (TACL 2024), Fig. 1, p. 158 / PDF p. 2
Nelson F. Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL 12 (2024), Fig. 1, p. 158. CC BY 4.0. 从正式 PDF 提取图面;图形、坐标、文字和图例未改。 · 许可
2.2 Framework
先说明设计为什么有效,再让读者追踪输入如何成为输出。大框对应 Method Overview,框内步骤对应方法小节。
- 结合一个案例画流程:输入、关键操作、中间产物、最终输出都要出现。NLP 展示处理后的文本,CV 展示中间图像或特征。
- 同类信息放一起;同层模块并排,真实先后关系用箭头。颜色表示职责,编号表示步骤,不靠满屏连线补逻辑。
- 铁律 箭头表示真实依赖。标清每步收到什么、做什么、交出什么、交给谁;训练、推理和评价分开。
- 铁律 边框区分输入、输出与仅供评价的材料,并给图例。参考答案或评价判据不能误画成被测模型的输入。
- 铁律 模块名称与正文一致,缩写、符号和颜色就近解释;同一来源案例只完整呈现一次,其他位置回引。
模板 1:输入、产物与评价分离
点击图可放大;窄屏可横向滚动。
前后使用同一任务。关键不是多画框,而是让每根箭头交代实际传递的材料;参考答案仅用于评价,不能连进回答生成流程。
StarPaper 原创教学改排,CC BY 4.0;非原论文修订记录。
模板 2:按职责分组,用案例串流程
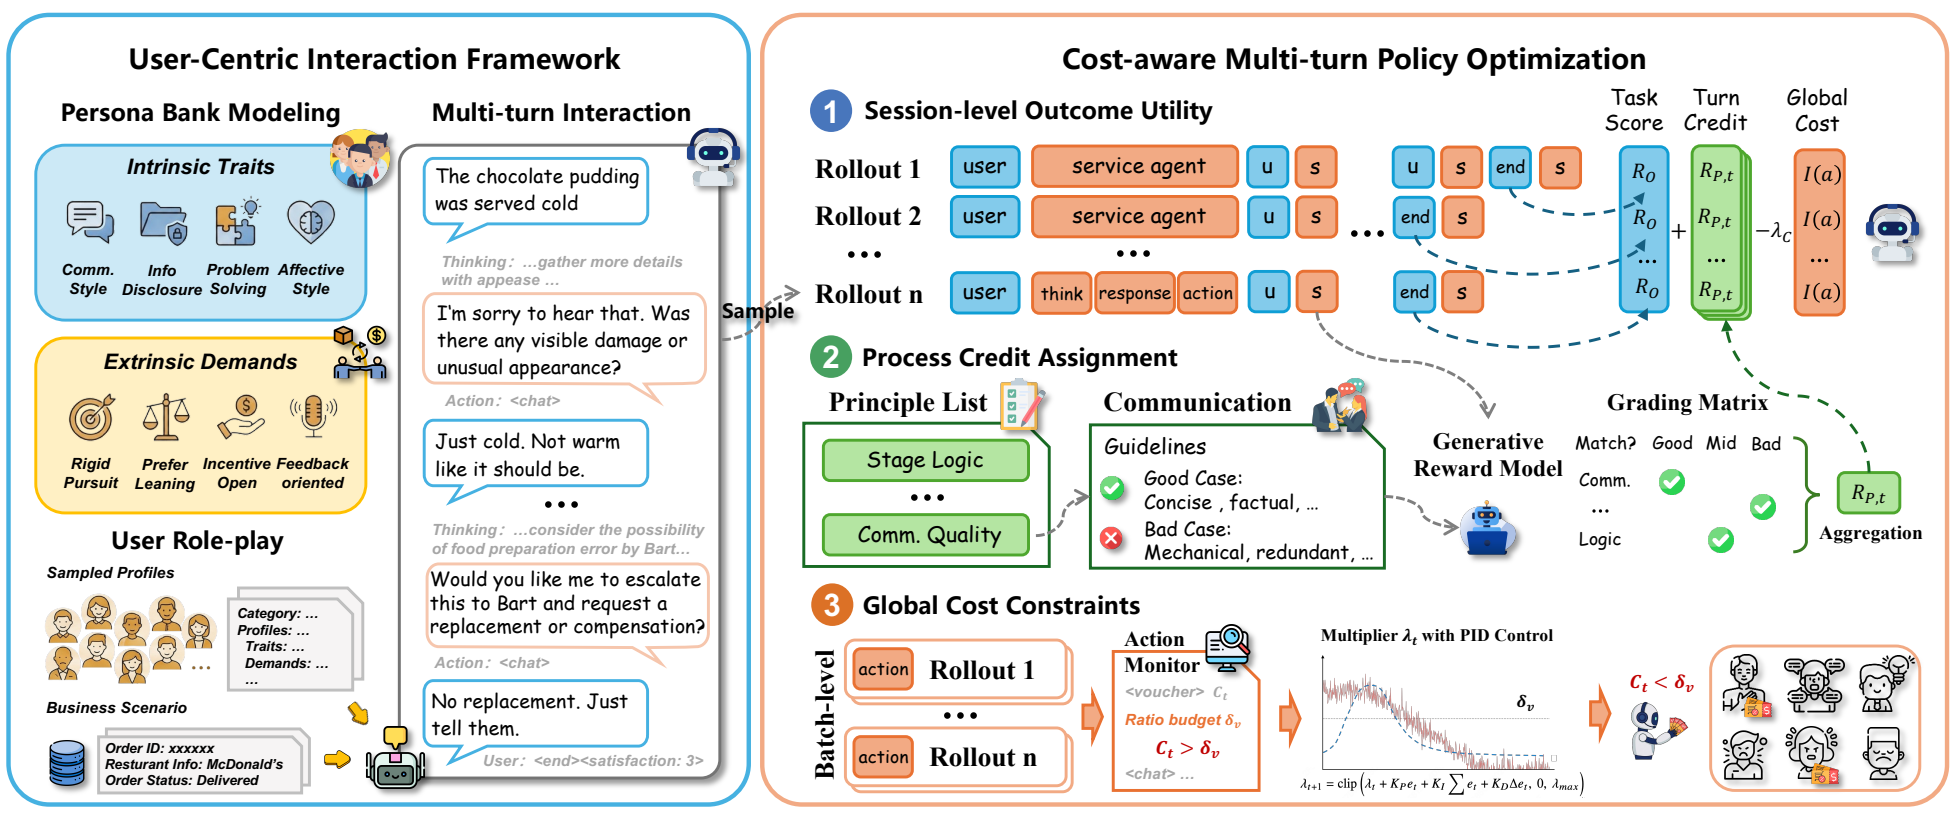
先按职责分组,再用案例连接抽象模块与实际产物。输入、回复与评分信号各占明确位置;学习这种组织方式,不照搬全部节点。
Ning Gao et al., Reinforcing Real-world Service Agents, arXiv:2602.22697v1, Fig. 1. CC BY 4.0. 从原页裁切;图形与数据未改。 · 许可
2.3 实验绘图
一张图回答一个实验问题。先选统计对象与比较方式,再调整配色、图例和标注。
- 少量方法比较用柱图或点图,训练动态用折线,分布用 KDE 或 ECDF;热图、投影、雷达等按需查附录,不为凑图换图型。
- 完整方法与删组件版本保持同顺序、同配色;再用线型、点形或纹理区分。少量柱可画细一些,透明度保留重叠;图例放空白处,关键点就近标注。
- 铁律 从真实记录绘制,保留缺测、下降和不确定性;不补点、不编误差、不为平滑改曲线。误差写明统计单位、类型与计算方法。
- 铁律 坐标有单位、方向和必要分母;同类面板保持可比尺度。柱图优先零起点,截断须明显标出;相对增益同时给绝对值,百分点与百分比区分。
- 铁律 统计图导出矢量 PDF 并嵌入字体,核对数值与图形对应。KDE 是密度,ECDF 才读累计比例;投影分开不证明泛化好,雷达面积不是综合分数。
模板 1:同一数据的排版优化
点击图可放大;窄屏可横向滚动。
排版修改不改柱高或数据。这里没有重复试验记录,因此不画误差棒;实际实验须保留并定义已有的不确定性。
StarPaper 原创教学数据与改排,CC BY 4.0;不是论文实验结果。
模板 2:多面板共用编码与图例
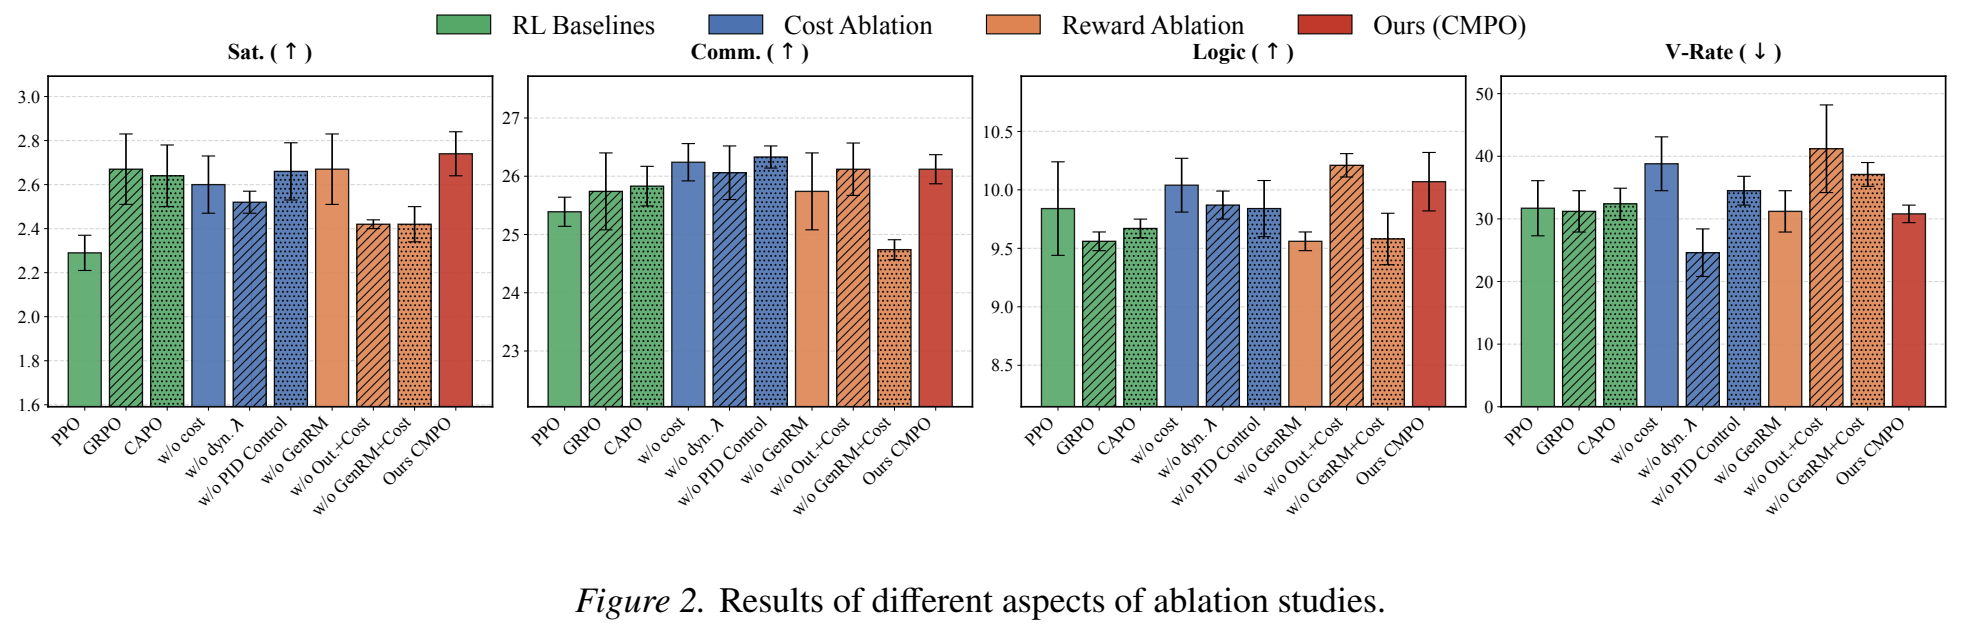
同一方法跨面板保持颜色和纹理,读者无需反复找图例。图面未定义误差棒,不能自行补成标准差或置信区间;前三图非零起点,应读数值差。
Ning Gao et al. · arXiv:2602.22697v1 · Fig. 2
Ning Gao et al., arXiv:2602.22697v1, Fig. 2. CC BY 4.0. 从原 PDF 裁切;图形与数据未改。 · 许可
3. 正文精修
先检查全文规范,再按章节精修。模板中的【】填自己的材料。
3.1 全文规范
“铁律”只标必须遵守或禁止违反的要求;未标记的是可调整的写法建议。官方规定优先,特定稿件的要求不套用到其他论文。篇幅利用和实验页呈现来自作者笔记,不是会议的最低页数规定。
篇幅与版面:充分呈现证据
- 铁律 遵守当轮篇幅要求:按会议上限和当前稿件明确的篇幅目标排版。要求写满时,补足有效证据、比较和解释;明显偏短可能让审稿人觉得实验和分析不足。不为凑页注水,不把单稿页数套到所有论文。
- 铁律 实验页有可见证据:正文末几页用于实验时,每页应有实际结果、分析图或对照表,与解释就近排。核心证据别全移附录,也不为凑页拆成零碎实验。
- 铁律 保留支撑结论的证据:不能为省篇幅删掉支撑结论的实验分析、必要条件和关键比较。超页建议先删重复和无关背景,再压缩 Related Work 与常规方法介绍。
- 铁律 保持官方模板:按当轮规则分别核查正文、参考文献与附录的页数,不改字号、行距、字距或页边距凑页。最终看 PDF,源码长度不能代替版面检查。
- 铁律 图表与正文一致:同一对象的名称、符号、单位、数值和范围对齐;图表就近引用,caption 解释读法。改图或改表后回查正文,避免留下两个版本。
逻辑:句子承接与对象一致
- 先说为什么值得做:每项设计都要回答:已有做法在哪种条件下不足,本文改了什么,为什么有用,哪项证据支持。
- 铁律 句子之间有逻辑关系:后句处理前句的问题或产物,Then 和 Therefore 须符合实际关系。
- 铁律 连接词用对:转折用 However,有推导依据才用 Therefore;展开已有判断用 Specifically,并列直接写。连接词由真实关系决定。
- 铁律 不虚构章节依赖:章首说明承接的问题或产物;确有后续用途时,章末说明产物交给谁。不把并行写成串行。Related Work 小节直接进入内容,Intro 以贡献列表结束,Conclusion 不预告不存在的下一步。
- 铁律 问题、设计、实验对应:引言提出的问题,方法处理,实验检验。
- 铁律 钩子连接真实关系:前句建立对象或前提,后句增加判断。Therefore 从证据归纳,Specifically 展开判断,However 说明具体转折;举例用 For example 或 For instance 起句。缺少某项设计后,紧接说明因此无法区分什么;连接词不能代替依据。
语言:完整判断与句长
- 用具体操作替代空泛评价:用具体操作替换 powerful、comprehensive 等空评价。
- 铁律 短句,完整动作:每句一个主要判断,不用分号把长句接回来。按最终 PDF 检查:常用双栏窄栏句子最多 3 行,单栏约 1.5 行;本稿另有明确要求时按本稿执行。保留动作、条件与承接,不缩字体或改模板。
- 铁律 正文写完整句子:正文用完整句子表达关系,不用加号、斜杠、与号或箭头代替文字;英文不用破折号插入解释,复合词连字符、数学、单位和图连线保留。
- 同级小节篇幅相称:任务相近,篇幅尽量接近;太长先查重复,复杂内容分段。
- 铁律 近距离用词去重:检查同句、相邻句和短段中的实义词、词根与起句重复。删冗余,不靠换同义词掩盖重复,也不删必要术语。
术语:首次定义与名称一致
- 铁律 术语首次解释:写清对象和用途,不让读者到后文找定义。
- 铁律 符号首次定义:写对象、来源、算法、用途和下标;不用的符号删掉。
- 铁律 同一对象同一称呼:同一对象同一名称;代词的对象须唯一、明确且就近。含混时换成短对象名,清楚的代词保留。
- 铁律 贡献词有事实依据:tailored、expert-confirmed、manually selected 等修饰须对应可核查工作。贡献对象与动作前置,修饰词不能代替贡献。
- 命名发现立即解释:发现需要命名时,选准确、好懂的短名,通常不超过四个英文词。定义和证据仍须给出,名称不能代替解释。
主张:证据与适用范围
- 铁律 保留结论条件:任务、模型、范围和分母写清;有限测试不推广所有场景。
- 铁律 观察与原因分开:先报告现象,再讲可能原因;匹配对照支持后才归因。
- 结果首句写发现:结果段首句给有依据的发现,随后给图表、关键比较和意义;先读完一段设置才找到结论,会增加阅读负担。
- 铁律 数字与统计口径准确:数字用阿拉伯数字,并能回查最新记录。子集给 n of N、单位与版本;区分百分比与百分点、宏平均与微平均。未知不填 0,不能换分母或单位夸大结果。
贡献与句间衔接
假设的文档问答任务;只演示句间承接与证据范围,不是论文原文或实测结果。
To make answers traceable to source evidence, [Method] records each retrieved quote with the corresponding manual location and relevant dialogue constraints1. These records form evidence notes2 that guide answer generation together with the current question and retained constraints. With the inputs and inference budget held fixed3, we compare note-guided generation with passage-only generation. Note-guided generation improves citation support by [support gain] but adds [latency cost] under [tested conditions]4, revealing a trade-off between traceable answers and response time.
为让答案依据可追溯,[方法] 记录每个检索摘句、对应的手册位置与相关对话约束1。这些记录构成证据笔记2,与当前问题及保留的约束共同指导答案生成。在固定输入与推理预算后3,我们比较笔记引导的生成与只使用片段的生成。在[实测条件]下,笔记引导的生成使引用支持率提高[提升幅度],但增加[延迟开销]4,说明答案可追溯性与响应时间存在取舍。
StarPaper · 教学改写
出处与复用范围
本段是原创教学示范。[support gain]、[latency cost] 与 [tested conditions] 必须由真实实验替换。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
按论文顺序精修
摘要概括全文,引言提问题,方法给做法,实验查效果,讨论讲范围,结论收尾。以下按实证型 CS / AI 论文组织。
- 3.2 标题:先把最值得记住的发现放进标题。
- 3.3 摘要:让人用一段话看懂为什么这项工作值得做。
- 3.4 引言:让读者认同问题,并记住你的解法为什么有用。
- 3.5 相关工作:说明已有路线、本文差异及其与核心贡献的关系。
- 3.6 方法:告诉读者为什么你的方法好,比解释清楚方法更重要。
- 3.7 实验:用对照检验贡献,解释主要差异与发现。
- 3.8 讨论:解释发现的意义,区分观察与机制。
- 3.9 局限性:用一个自然段写清两项与任务相关的具体边界。
- 3.10 结论:回答开头的问题,概括贡献和发现。
- 3.11 参考文献:引用回查原文,信息和版本对齐。
- 3.12 附录:提供可定位、可复核的设置与补充材料。
逐句示范有论文原文短引,也有明确标注的模拟段落。原文例子来自不同论文,不拼接成同一篇完整论文;模拟部分用同一个假设任务串联。
3.2 标题
先把最值得记住的发现放进标题。
本节原则
- 标题交代研究对象和核心贡献;方法名后说明做了什么,发现型论文可直接写关键发现。记忆点要准确、好懂。
- 铁律 标题中的能力与发现须有正文证据,不能把诊断问题写成已解决问题。
标题结构
论文原文短引 · 中文为本指南翻译
Careful Queries, Credible Results1: Teaching RAG Models Advanced Web Search Tools2 with Reinforcement Learning3
谨慎查询,可信结果1:通过强化学习3教会 RAG 模型使用高级网页搜索工具2。
WebFilter · AAAI 2026 · Title,PDF第1页(刊页30458);AAAI 2026 camera-ready;2026-03-14正式发表
出处与复用范围
去除LaTeX排版与文献标记、合并换行;原词句未改。 数学符号改为可读文本形式。
©2026 AAAI. All rights reserved. 独立保留原论文版权;未授予StarPaper整篇或原图再许可。
3.3 摘要
让人用一段话看懂为什么这项工作值得做。
本节原则
- 铁律 摘要一个自然段,按背景、具体 limitation、对应方法与亮点、实验亮点组织。不用设问或术语定义代替不足;缺一环,就看不出研究为何必要、做了什么或证据是什么。长度服从会议要求。
- 铁律 贡献对象和动作尽早出现。关键改动要回应前句的不足,不先堆流程和数量。
- 铁律 必要术语首次解释,缩写给全称;句间的对象与逻辑关系明确,不能让读者猜。
- 结果优先保留有信息增量的发现及比较范围,不机械以最大数字结尾。摘要通常不放引文,按会议要求处理。
- 铁律 摘要解法逐点写 For [具体 limitation], we [实际动作与贡献].,点名前文同一限制。
- 铁律 改动摘要或引言后,回读另一节;问题、设计、命名、数字、模型范围和因果方向持续对应,不逐字照抄。
摘要结构
假设教学段落,非论文原文或实测结果。
Document-based dialogue requires answers that respect both source evidence and evolving user constraints1. Passage-only generation supplies relevant text without explicitly recording which dialogue constraints the source quotes support2. For this missing evidence-to-constraint link, we introduce structured evidence notes that pair source quotes with manual locations and active dialogue constraints.3 These notes let the generator cite sources and explain how the evidence relates to each constraint. In our comparison on static English manuals, notes increase citation support relative to direct generation but add latency4. The comparison evaluates source support; the support scores do not establish that every user constraint is satisfied5.
基于文档的对话要求答案同时符合来源证据与不断变化的用户约束1。只使用片段的生成方式提供相关文本,却不明确记录来源摘句支持哪些对话约束2。针对证据与约束之间缺少对应记录的问题,我们提出结构化证据笔记,将来源摘句与手册位置及当前有效的对话约束配对。3这些笔记帮助生成器引用来源,并说明证据与各项约束的关系。在针对静态英语手册的比较中,相比直接生成,笔记提高了引用支持率,但增加了延迟4。这个比较评价的是来源支持,不能据此认定每项用户约束都得到满足5。
StarPaper · 教学改写
出处与复用范围
沿用文档问答的假设任务,展示信息顺序与论证作用,不代表新增研究结果。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
3.4 引言
让读者认同问题,并记住你的解法为什么有用。
本节原则
- 铁律 钩子承接前文真实问题、困难或产物,不能错置转折、目的与因果。However 可写转折,Therefore 据前述证据归纳,Specifically 展开判断;不是每段都要出现这些词。
- 铁律 前两段可穿插、合并或拆分,但要有领域回顾与已有方法比较。回顾给局限铺路:后面批评什么,前面先说明已有方法怎样处理它。
- 铁律 挑战名称本身就要显示困难:什么缺失、什么难以完成、什么阻碍目标。随后解释原因和影响,中性任务属性不能直接当挑战名。
- 铁律 贡献对象与动作尽早出现。expert-confirmed、manually selected、tailored 等词要对应实际工作;写清选择依据,不用“高质量”代替依据。
- 铁律 方法段首承接已建立的障碍;方法名后同一句说明产物、核心设计与用途。随后逐项点名困难及对应解法,服从当前人工定版,不把 Therefore 或 To solve 设为永久必需。引言讲设计思路,实现细节留给 Method。
- 结果段可先接回研究问题,再概述发现;摘要压缩、引言展开,不逐字重复,不把排名当分析。
- 铁律 摘要、引言及正文的问题、设计、名称、数字、范围与因果方向一致;每次修改后回读对应部分。局限沿用同一名称,Related Work 给比较依据,Method 说明设计,实验提供检验。
- 铁律 结果概述对应正文实际结论。若实验只支持某些任务或条件,摘要、引言、讨论和结论都限定到相同范围。
- 铁律 引言只引用属于本节的图表;不提前指向后文方法、实验、附录的图表、公式或章节,也不写“见后文”。文献 citation 与有依据的结论保留。
- 铁律 引言中的正式命名对象每次出现用斜体,强调性加粗对同一对象全节最多一次;贡献列表不重置次数,普通专业词不机械斜体。
- 铁律 普通正文引导句后接原生 itemize,固定三项:工作概述、新机制与实际用途、实验发现。第 2 项用 We propose [机制] 点名真正的新设计,说明依据、具体作用及实际应用;正文已建立问题与解法时,不再重复障碍标签。第 3 项给证据范围,新名称首次就近定义,列表后直接下一节。
引言写作模板
先在 1.2 正文结构选择全文组织,再按同一类型精修引言。方括号填自己的材料;前两段完成领域回顾与比较,可穿插或合并。各模板最后均接贡献总结,格式见 1.2。
方法型引言
核心贡献是新方法或新的系统设计。
领域与研究问题
[research area] aims to [goal] by mapping [input] to [output]. Recent [approach family] can [supported capability] [citations]. These capabilities support [application], where [task requirement] matters for [practical objective]. This requirement motivates [research question].
先说研究对象、已有能力和实际要求,再让研究问题从这些要求中自然出现;背景与下一段的回顾可穿插。
比较依据与局限
Existing [approach family A] uses [input A] to [supported operation A] [citations], whereas [approach family B] relies on [input B] to [supported operation B] [citations]. However, [specific limitation] restricts [required capability] because [documented cause or operating assumption]. Under [relevant condition], this restriction leads to [observable consequence]. Addressing it requires [corresponding design requirement].
比较同一维度,用 However 点出自明的局限,再说它为什么妨碍目标;紧接下一段的解法,不插入无关回顾。
对应设计与贡献
To address these obstacles, we introduce [method name], a [verified distinguishing design and purpose]. For [specific limitation], we [concrete design action and contribution] to meet [corresponding design requirement]. It takes [input] and produces [output] through [high-level mechanism]. For [another established limitation, if present], we [next design action] using [preceding output] to [corresponding purpose]. Together, these designs enable [supported capability] under [stated conditions].
铁律 方法名后立即交代亮点和用途;解法钩子点名前文同一个局限并给对应动作。每项设计有依据,正面修饰能从来源、操作或结果中核查。
实验概述与结论边界
To answer [research question], we compare [method name] with [appropriate baselines] under [shared evaluation conditions]. Experiments show [verified main finding] on [metric or measured outcome] within [tested scope]. To examine [design motivation], [ablation or controlled comparison] tests [specific design choice] and shows [verified design finding]. Further analysis identifies [supported pattern or remaining limitation], indicating [bounded answer to the original question].
先概述发现,再展开设计检验和分析;与摘要、实验、结论使用同一发现和范围,不自动填写最优、显著提升或因果收益。
贡献总结
In summary, our contributions are:
\begin{itemize}
    \item We introduce [research object], which supports [task] with [verified distinguishing feature].
    \item We propose [mechanism], derived from [verified basis], which [specific function] and supports [actual application].
    \item Experiments within [tested scope] reveal [verified finding]. Further diagnosis identifies [supported recurring problems].
\end{itemize}
铁律 普通正文引导句后接原生 itemize,固定三项:工作概述、新机制与实际用途、实验发现。第 2 项用 We propose [机制] 点名真正的新设计,说明依据、具体作用及实际应用;正文已建立问题与解法时,不再重复障碍标签。第 3 项给证据范围,新名称首次就近定义,列表后直接下一节。
基准与数据集型引言
核心贡献是新的数据集、基准或评价协议。
能力与评价问题
Progress in [research area] enables [supported capability] [citations]. These capabilities support [application], where [condition relevant to the task] affects [required behavior]. Evaluating this behavior requires [observable input or evaluation property]. This requirement raises [research question].
先说明为什么需要评价这个具体能力,研究问题须落到可观察的输入、行为或结果。
已有基准与评价缺口
Existing [benchmark family A] measures [evaluation target A] using [reported inputs and criteria] [citations]. [benchmark family B] instead evaluates [evaluation target B] under [reported setting] [citations]. However, [specific evaluation limitation] limits evaluation of [specific required capability], as shown by [evidence-bounded comparison]. [required input or criterion] is needed to distinguish [behavior of interest] from [alternative behavior], so [corresponding evaluation design] is necessary.
按输入、判据和目标对应比较,缺失、未报告、未公开分开写;明确这个缺口让哪一种行为无法被区分。
建设障碍与设计要求
However, establishing [required evaluation] faces [self-explanatory construction obstacle]. [documented source or annotation constraint] makes [required construction step] difficult. In addition, [another independent obstacle, if present] limits [another necessary step] because [documented reason]. Addressing these obstacles is necessary to obtain [usable evaluation artifact] for [research question].
建设困难不同于前人的评价缺口;每个困难写清受阻步骤和后果。没有独立的第二项就删去对应句,必要时与前段合并。
数据、判据与核心贡献
To address these obstacles, we introduce [artifact name], a [verified source or distinguishing design] for [evaluation purpose]. For [data construction obstacle], we construct [data contribution] from [verified source] using [documented selection or collection rule]. For [specific evaluation limitation], we [evaluation contribution and action] to measure [capability linked to the earlier gap]. The tested system receives [task input], while [evaluation evidence or criteria] is used by [evaluator] to assess [system output]. These components support [supported evaluation capability] within [coverage boundary].
铁律 先突出产物,再写可执行的来源与构建依据;解法钩子复用评价局限名称。受测系统输入与评分材料分开,数据与判据分别接回对应困难。
基准结果与研究发现
To answer [research question], we evaluate [systems or model families] using [shared protocol]. Results reveal [verified main finding] within [tested scope]. Specifically, [named finding, if useful] describes [observed behavior or result contrast]. To examine [observed limitation], [diagnostic analysis] shows [supported diagnostic finding]. These results indicate [bounded implication] and leave [remaining question] unresolved.
结果段先给实际发现,不从模型名单或指标层级开讲;命名现象紧接含义,诊断回扣原问题且不扩大为未经检验的机制。
贡献总结
In summary, our contributions are:
\begin{itemize}
    \item We introduce [research object], which supports [task] with [verified distinguishing feature].
    \item We propose [mechanism], derived from [verified basis], which [specific function] and supports [actual application].
    \item Experiments within [tested scope] reveal [verified finding]. Further diagnosis identifies [supported recurring problems].
\end{itemize}
铁律 普通正文引导句后接原生 itemize,固定三项:工作概述、新机制与实际用途、实验发现。第 2 项用 We propose [机制] 点名真正的新设计,说明依据、具体作用及实际应用;正文已建立问题与解法时,不再重复障碍标签。第 3 项给证据范围,新名称首次就近定义,列表后直接下一节。
诊断驱动的改进研究引言
先通过诊断发现问题、定位瓶颈,再据此提出改进。全文先讲 Diagnostic Analysis,再讲 Method 与验证;不能只把发现塞到常规方法型结尾。
已有能力判断与可检验问题
[research area] seeks to [goal]. Existing [approach family] achieves [supported result] under [reported conditions] [citations]. However, it remains unclear whether this result demonstrates [target capability]. If the capability holds, [testable expectation] should be satisfied under [controlled condition].
先区分已有成绩与它被解释成的能力,再用 However 提出可检验质疑。背景与比较可穿插,不硬套段落数。
诊断设计与关键发现
To test this expectation, we construct [diagnostic comparison] by changing [target condition] while preserving [relevant controls]. The comparison reveals [verified diagnostic finding]. Further [discriminating control or process analysis] shows [supported bottleneck evidence], suggesting that [bounded interpretation]. These observations motivate [design requirement].
诊断先于方法。写清改变与保留条件,发现接到有依据的瓶颈;未检验的机制不写成事实。
针对瓶颈的设计
To address these obstacles, we introduce [method name], a [distinguishing design and purpose]. For [diagnosed bottleneck], we [concrete design action] to [corresponding role]. For [another established bottleneck, if present], we [next design action] using [preceding output] to [corresponding role]. [training or execution procedure] combines these components to produce [output].
核心动作靠前,每项设计接到前面的诊断。没有独立第二项就删去;训练或推理按实际方法写。
回到诊断的改进验证
To answer [original capability question], we evaluate [method] on [main task] and repeat [original diagnostic comparison]. Results show [verified main finding] and [verified finding under diagnostic conditions]. Further [process analysis or controlled ablation] examines [design motivation] and yields [verified result]. Together, these tests support [bounded conclusion] within [tested scope].
主任务表现、诊断复测和过程检验各有职责。先概述关键发现,再展开对应证据;结论回答最初的能力质疑。
贡献总结
In summary, our contributions are:
\begin{itemize}
    \item We introduce [research object], which supports [task] with [verified distinguishing feature].
    \item We propose [mechanism], derived from [verified basis], which [specific function] and supports [actual application].
    \item Experiments within [tested scope] reveal [verified finding]. Further diagnosis identifies [supported recurring problems].
\end{itemize}
铁律 普通正文引导句后接原生 itemize,固定三项:工作概述、新机制与实际用途、实验发现。第 2 项用 We propose [机制] 点名真正的新设计,说明依据、具体作用及实际应用;正文已建立问题与解法时,不再重复障碍标签。第 3 项给证据范围,新名称首次就近定义,列表后直接下一节。
实证发现型引言
核心贡献是新的经验规律、系统比较或对既有解释的检验。
现象与研究问题
Understanding [research phenomenon] matters for [scientific or practical objective]. Prior [research route] establishes [supported finding] within [previously studied scope] [citations]. This evidence motivates [specific question about the phenomenon]. Answering this question requires distinguishing [competing possibilities] under [relevant condition].
把已知事实和未回答的问题分开,提前说明需要区分什么;与下一段的文献回顾可灵活合并。
已有证据与检验缺口
Existing studies examine [relationship or behavior] using [reported design] [citations]. They provide evidence for [supported interpretation] under [documented assumptions or scope]. However, [specific evidence limitation] prevents these results from resolving [research question]. A comparison that [required contrast or measurement] is needed to distinguish [explanation A] from [explanation B].
点出证据还不能回答的问题,紧接需要怎样检验;别把没测过写成失败,也别把相关性写成原因。
研究设计与可检验贡献
To address these obstacles, we introduce [study or analysis], a [verified distinguishing design] for testing [research question]. For [specific evidence limitation], we [core comparison or measurement]. We compare [groups or conditions] that differ in [examined factor], using [documented control or adjustment] to examine [alternative explanation]. [measurement or analysis contribution] measures [observable outcome] using [verified data or procedure]. This design estimates [precise quantity or relationship] within [study population and conditions].
铁律 解法钩子点名证据缺口,贡献落到可复核的比较或测量。受控实验交代改变因素;观察研究交代自然差异、调整及估计对象,不把调整写成排除所有解释。
主要发现与解释范围
To answer [research question], we analyze [evidence] under [reported study conditions]. The results show [verified main relationship or contrast]. Further [robustness check or independent analysis] examines [specific alternative explanation] and yields [verified result]. These findings support [evidence-bounded interpretation] within [tested scope], while [unresolved limitation] restricts [claim or generalization].
先陈述发现,再说检验排除了什么、仍未排除什么;主结果和稳健性检查各有对象,最后回到同一研究问题与边界。
贡献总结
In summary, our contributions are:
\begin{itemize}
    \item We introduce [research object], which supports [task] with [verified distinguishing feature].
    \item We propose [mechanism], derived from [verified basis], which [specific function] and supports [actual application].
    \item Experiments within [tested scope] reveal [verified finding]. Further diagnosis identifies [supported recurring problems].
\end{itemize}
铁律 普通正文引导句后接原生 itemize,固定三项:工作概述、新机制与实际用途、实验发现。第 2 项用 We propose [机制] 点名真正的新设计,说明依据、具体作用及实际应用;正文已建立问题与解法时,不再重复障碍标签。第 3 项给证据范围,新名称首次就近定义,列表后直接下一节。
段落承接
句首钩子点名前文的问题或产物。摘要解法用 For [具体 limitation], we ...;引言逐项接回同一困难,方法名后立即给亮点与用途。连接词服从真实关系与当前人工定版,不固定 Therefore 或 To solve。
填空对应图。摘要压缩问题、贡献与发现,引言展开依据与作用;箭头连接同一主张,不规定段数。
Abstract · 问题
[research area] concerns [task or phenomenon]. Existing evidence leaves [specific limitation], motivating [research question].
Abstract · 贡献
For [specific limitation], we introduce [name], which uses [core design] to [purpose].
Abstract · 发现
Experiments show [verified main finding] within [tested scope].
引言列出全文要回答的问题。相关工作给依据,方法给设计,实验给检验,讨论与结论收束解释和范围。
这是可填空的功能对应图,不规定句数、段数或局限数量。方括号填同一组对象;同色高亮与箭头表示哪些内容必须相互对应。
Q · 研究问题:全文回答同一个具体问题。
L → M → E · 局限、设计与检验:前人的哪项不足,由哪项设计处理,用什么证据检验。
D · 实施困难:完成本文研究时遇到的困难;有必要才单独展开。
B · 本文剩余局限:限定本文已经解决到哪里,和前人局限 L 分开。
引言句子的任务正文怎样展开与检验
A · 背景与已有研究
[已有研究]已经说明[已知能力或发现],这些结果支持[应用目标或进一步研究]。
句首钩子These findings motivate [the research question].
背景不占用本文贡献;前人已经提供的能力须承认并引用。
Q · 研究问题
[研究背景或实践需求]提出[具体研究问题 Q]。
句首钩子To answer [the specific research question], we ...
任务、指标与结论测的是同一对象和能力;代理指标的改善不能直接写成未测过的真实应用收益。
L1 → M1 → E1 · 已有局限与对应解法
However, [已有路线]在[具体范围]存在[局限 L1],因而妨碍[目标 Q]。For [局限 L1], we [设计 M1 的具体动作].
句首钩子For [limitation L1], we [specific design action].
三处沿用同一个局限名称和比较范围。“未报告”不写成“没有”;只有整套系统对比时,不能宣称单个设计造成了收益。
L2 → M2 → E2 · 另一项独立局限(按需)
此外,[独立局限 L2]影响[另一必要能力]。For [独立局限 L2], we [设计 M2 的具体动作].
句首钩子For [limitation L2], we [specific design action].
有独立不足才增加这条链;不为凑“两项局限”重复同一问题。
D · 实施困难(按需)
完成[研究任务]还受到[实施困难 D]约束;这会阻碍[必要步骤]。
句首钩子Establishing [the required artifact] requires [specific step].
D 是本研究怎样完成的困难,不等于前人局限 L;来源或权限问题须按实际交代,不能省略会影响判断的信息。
M · 核心设计与贡献
To address these obstacles, we introduce [name], a [核心亮点与用途]。For [同名局限], we [核心设计的具体动作].
句首钩子For [named limitation], we [concrete contribution].
引言交代亮点与用途,方法给实现依据,实验给检验;产物介绍、流程说明和效果证据各有职责。
E → Q · 主要发现
To answer [Q], we evaluate [研究对象] under [条件]。实验发现[主要结论 E],回答了[Q 的哪一部分]。
句首钩子To examine [the motivated capability], we compare [objects].
实验结论必须回到最初动机;缺少受控检验时不补因果解释,案例展示也不能代替总体频率。
C / B · 贡献与结论范围
本文提供[新增贡献 C]并揭示[实际发现];结论限于[已验证范围],仍受[本文剩余局限 B]约束。
句首钩子Within [the evaluated conditions], [supported conclusion].
L 是前人的不足,B 是本文解决到哪里。真正限制核心主张的 B 须体现在相应主张中,不要求把所有局限都塞进引言。
L1 → M1 → E1 → Q:[具体局限] → [针对它的设计] → [能检验设计作用的比较] → [对研究问题的实际回答]。
其他主张:数据质量、效率、泛化或机制主张同样需要对应证据;按实际贡献增加,不能只靠同一句钩子。
结果回写:实际发现及范围 → 摘要、引言的贡献与发现 → 讨论与结论。结果或证据范围变了,对应主张一起改。
困难与评价目标
教学改写,非论文原文或实测结果;方括号替换自己的材料。
However, answering this question faces two obstacles.1 First, data scarcity limits access to real commercial conversations, and identifying complex or ambiguous needs requires costly expert annotation2. Second, case-dependent standards complicate evaluation: clothing recommendations require color and outfit coordination, whereas phone recommendations require different suitability checks. Even within one category, requirements and risks vary across cases.3 A fixed checklist can miss these differences. Together, these obstacles hinder accurate evaluation of LLMs on complex, ambiguous, and time-sensitive shopping requests.4
然而,回答这个问题有两个困难。1首先,数据稀缺使真实商业对话难以获取,识别复杂或模糊的需求还需要成本较高的专家标注2。其次,随案例变化的标准增加了评价难度:服装推荐要考虑颜色与穿搭搭配,手机推荐则要检查其他适配条件。即使是同类商品,不同案例的需求与风险也会变化。3一张固定清单可能漏掉这些差异。这两类困难共同妨碍了对 LLM 处理复杂、模糊且有时效性的购物请求进行准确评价。4
StarPaper · 教学改写
出处与复用范围
根据作者提供的修改意见撰写的教学段落,不含当前稿件名称、数据数量、模型名单或未经核对的基准比较。Figure [X] 为图号占位。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
设计与专家产物
教学改写,非论文原文或实测结果;方括号替换自己的材料。
Therefore, to address these obstacles, we introduce [Benchmark], an evaluation resource that preserves changing needs and unresolved conditions. Business experts screen cases in de-identified shopping conversations. Each case retains timestamped dialogue, including changed needs and unanswered questions. Experts distill Ideal Response Principles1 from excellent replies manually selected from completed transactions2. These principles guide case-specific criteria across Core, Excellence, and Safety3 and inform a tailored reasoning prompt. The tiers assess required completion, added value, and risk avoidance, respectively. Our example (Figure [X]) illustrates how elapsed time and unresolved information affect the advice a case requires.4
因此,为处理这些困难,我们提出【Benchmark】,一个保留变化需求与未决条件的评价资源。业务专家从去标识化的购物对话中筛选案例。每个案例保留带时间戳的对话,包括发生变化的需求和未得到回答的问题。专家提炼出理想回复原则1,依据的是从成功交易中手工筛选出的优秀回复2。这些原则指导针对每个案例制定 Core、Excellence 和 Safety 三层标准3,并用于设计专门的推理提示词。三层分别评价必要要求的完成、额外价值和风险规避。我们的例子(图【X】)说明时间推移和未决信息如何影响一个案例所需的建议。4
StarPaper · 教学改写
出处与复用范围
根据作者提供的修改意见撰写的教学段落,不含当前稿件名称、数据数量、模型名单或未经核对的基准比较。Figure [X] 为图号占位。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
发现与分析
教学改写,非论文原文或实测结果;方括号替换自己的材料。
To answer this question1, we evaluate [commercial models] and [open-weight models]. Across these models, we observe Product Evidence Overreach, where replies add unsupported product claims, and Shopping Uncertainty Collapse, where unresolved needs are treated as settled.2 These failures may make shopping advice less reliable. Further analysis links these failures to changing requirements and unresolved information.3
为回答这个问题1,我们评价【商业模型】与【开放权重模型】。在这些模型的回复中,我们观察到两类失败:Product Evidence Overreach,即回复添加了缺少证据支持的商品声明;Shopping Uncertainty Collapse,即将尚未确定的需求视为已经明确。2这些失败可能降低购物建议的可靠性。进一步分析将这些失败与需求变化和未决信息联系起来。3
StarPaper · 教学改写
出处与复用范围
根据作者提供的修改意见撰写的教学段落,不含当前稿件名称、数据数量、模型名单或未经核对的基准比较。Figure [X] 为图号占位。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
领域回顾
高亮与旁批按颜色和编号对应;点击切换中英。
Humans spend nearly 90% of their time indoors [12], and the built environment contributes a substantial share of global carbon emissions [34, 65, 66]. Thus, building design sits at the nexus of daily life and sustainability1. Traditional design relies heavily on expert knowledge and extensive manual iteration2 [2, 14, 20], often taking days to months to reach viable solutions. Recent advances in generative models on controllable [5, 32, 47] and multimodal generation [7, 24, 50] pave the way for automated building design generation3.
人们近 90% 的时间在室内度过 [12],建筑环境也占全球碳排放的相当大一部分 [34, 65, 66]。因此,建筑设计连接着日常生活与可持续性1。传统设计高度依赖专家知识和大量人工迭代2 [2, 14, 20],往往需要数天至数月才能得到可行方案。近期,可控生成 [5, 32, 47] 和多模态生成 [7, 24, 50] 的进展,为建筑设计的自动生成铺平了道路3。
GreenPlanner · CVPR Findings 2026 · §1 Introduction,第一自然段,p.8596
出处与复用范围
英文保持原文,仅还原 PDF 换行、断词与字体连字。中文、高亮和旁批为本指南添加;保留原文引文编号。
原权利人保留版权;CVF Open Access 未声明 CC BY。本指南仅作署名教学短引,不重新发布全文或原图,不向第三方转授原论文版权。
已有能力与研究缺口
高亮与旁批按颜色和编号对应;点击切换中英。
To enable automation, prior works have employed conditioned generators [22, 31, 37, 38, 44, 48, 49, 59, 60, 63, 64] that translate coarse user requirements into concrete floorplan layouts1. However, existing methods rely solely on user-specified conditions and thus often violate unspecified real-world design constraints2. This neglect results in over 60% of samples in existing datasets [48] being practically unusable due to excessive energy use and flawed spatial-functional design. Some methods [38, 44] even fail to generate essential structural components such as windows, leading to unrealistic energy evaluations. Therefore, enforcing design constraints in generative models3 remains a major bottleneck for practical deployment.
为实现自动化,已有工作采用条件生成器 [22, 31, 37, 38, 44, 48, 49, 59, 60, 63, 64],将用户的粗略需求转为具体平面布局1。然而,现有方法仅依赖用户明确给出的条件,因此往往违反未被明确提出的现实设计约束2。这种忽视使现有数据集 [48] 中超过 60% 的样本因能耗过高、空间与功能设计不合理而无法实际使用。一些方法 [38, 44] 甚至无法生成窗户等必要结构,导致能耗评估不符合现实。因此,在生成模型中落实设计约束3,仍是实际部署的主要瓶颈。
GreenPlanner · CVPR Findings 2026 · §1 Introduction,第二自然段,p.8596
出处与复用范围
英文保持原文,仅还原 PDF 换行、断词与字体连字。中文、高亮和旁批为本指南添加;保留原文引文编号。
原权利人保留版权;CVF Open Access 未声明 CC BY。本指南仅作署名教学短引,不重新发布全文或原图,不向第三方转授原论文版权。
结构模板
贡献列表
In summary, our contributions are:
\begin{itemize}
    \item We introduce [research object], which supports [task] with [verified distinguishing feature].
    \item We propose [mechanism], derived from [verified basis], which [specific function] and supports [actual application].
    \item Experiments within [tested scope] reveal [verified finding]. Further diagnosis identifies [supported recurring problems].
\end{itemize}3.6 方法
告诉读者为什么你的方法好,比解释清楚方法更重要。
本节原则
- 为什么你的方法好,比解释清楚方法更重要。每项关键设计接回 Intro 的具体困难,再讲怎样实现。
- 铁律 写清真实输入、要求输出和约束;存在训练、推理或评价阶段时,分别说明可见信息,不能把仅供评价的材料写成模型输入。
- 铁律 Overview 先接回 Intro 的困难,再按真实输入输出概括交接。用准确章节名与 ref 定位,每节只引一次,实际执行者作主语,末句指向 framework;保留并行、循环与反馈,否则总览会误导实际流程。
- 铁律 方法模块、subsection 和 Step 的正文开头先交代具体动机,用 To [具体问题或目的], [真实执行者] [设计或动作] 接回问题,再讲设计依据、输入输出与必要实现。目的不能反复写成泛泛的质量提升,Overview 的承接句不机械重复 To。
- 主要篇幅留给自己的设计,标准操作简写;长 prompt 和额外细节可放附录,正文给入口。
- 铁律 符号先讲普通含义,再定义对象、单位、下标与信号来源。关键计算用独立 equation / align 并编号,公式作为完整句保留标点;短定义行内写,不给普通操作造无用公式。
- 铁律 框架图、Overview、小节和粗体模块名必须对应真实步骤;图文各说一套,读者就无法追踪同一个方法。
- 铁律 说明外部模型、检索器、仿真器等组件的职责与来源,明确本文改了哪一部分;使用现成组件不等于提出新方法。
- 铁律 正文说明参数作用,Implementation Details 交代真实数值、搜索、版本与来源;不编参数,不删除复现所需信息。
任务定义
教学改写;示例方法与实验设置仅用于说明写法,不是已发表论文原文或实测结果。
Given a question, the dialogue history, and a collection of English manuals1, the task is to generate an answer that respects earlier constraints and cites supporting passages2. At inference time, the system receives these inputs but no reference answer3. We use reference answers only for evaluation. A prior requirement such as offline operation remains part of the task unless the user explicitly changes it4.
给定一个问题、它的对话历史和一组英语手册1,任务是生成遵守前文约束、附有支持片段引用2的回答。推理时,系统接收这些输入,但不接收参考答案3。参考答案仅用于评价。离线操作等前文要求仍属于当前任务,除非用户明确更改4。
StarPaper · 教学改写
出处与复用范围
独立教学示例,使用静态手册问答说明组织方式,不对应私有项目。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
方法概述
教学改写;示例方法与实验设置仅用于说明写法,不是已发表论文原文或实测结果。
To retain earlier constraints during answering1, we connect quoted evidence to the dialogue history before generating an answer. In History-aware Retrieval (Sec. [retrieval]), we select2 manual passages relevant to the current question and earlier requirements. Using these passages3, in Constraint-linked Notes (Sec. [notes]), we attach the requirements to source quotes and retain their manual locations. Finally, in Grounded Answering (Sec. [answering]), the generator uses the resulting notes4 to produce an answer with source citations. Figure [framework] shows these dependencies.5
为在回答中保留前文约束1,我们先把摘录证据与对话历史关联,再生成答案。在历史感知检索(第[retrieval]节)中,我们筛选2与当前问题及前文需求相关的手册片段。使用这些片段3,我们在约束关联笔记(第[notes]节)中将需求绑定到来源摘句,并保留手册位置。最后,在基于证据的回答(第[answering]节)中,生成器使用所得笔记4生成带来源引用的答案。图[framework]展示这些依赖关系。5
StarPaper · 教学改写
出处与复用范围
独立教学示例,使用静态手册问答说明组织方式,不对应私有项目。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
组件设计
教学改写;示例方法与实验设置仅用于说明写法,不是已发表论文原文或实测结果。
To keep earlier requirements available during answering1, the note builder links each retrieved quote to the relevant dialogue constraint. A retrieved passage may describe a feature correctly yet be unsuitable for an offline-only request2. For each quote, we record the manual location and the constraint supported or contradicted by the quote3; an unverified relation is left unresolved4. The generator then receives these notes together with the current question5, so the answer can cite the source and explain whether the requirement is met.
为让回答阶段仍能使用前文要求1,笔记构建器将每条检索摘句与相关对话约束关联。一个片段可能准确描述功能,却不适用于仅限离线的请求2。对每条摘句,我们记录它在手册中的位置,以及它支持或违背的约束3;尚未核验的关系保留为未确定4。生成器随后接收这些笔记和当前问题5,以便回答引用来源,并解释要求是否满足。
StarPaper · 教学改写
出处与复用范围
独立教学示例,使用静态手册问答说明组织方式,不对应私有项目。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
组件衔接
高亮与旁批按颜色和编号对应;点击切换中英。
We propose GreenPlanner, an energy- and functionality-aware generative framework for residential design1 (Fig. 2). It integrates four components: (1) Design Feasibility Dataset (DesignFD), a dataset built from RPLAN [48] via expert-verified energy and functional evaluations2; (2) Practical Design Evaluator (PDE), a predictor trained on DesignFD for fast simulation of energy and functional feasibility3; (3) Green Plan Dataset (GreenPD), a PDE-guided dataset pairing user requirements with regulation-compliant layouts4; and (4) GreenFlow, a generator trained on GreenPD with PDE feedback5 for controllable, constraint-grounded layout generation. We next describe each component of the framework in detail.
我们提出 GreenPlanner,一套同时考虑能耗与功能的住宅设计生成框架1(图 2)。该框架集成四个组件:(1)设计可行性数据集(DesignFD),由 RPLAN [48] 经专家核验的能耗与功能评估2构建;(2)实用设计评估器(PDE),在 DesignFD 上训练,用于快速模拟能耗与功能可行性3;(3)绿色规划数据集(GreenPD),由 PDE 引导,将用户需求与符合规范的布局配对4;(4)GreenFlow,在 GreenPD 上训练并使用 PDE 反馈5,生成可控且以约束为依据的布局。下面将详细介绍框架的各个组件。
GreenPlanner · CVPR Findings 2026 · §3 Method,开头自然段,p.8597
出处与复用范围
英文保持原文段落,仅合并换行、还原排版断词与字体连字,规范引文括号空白;高亮和批注为本指南添加。中文为本指南翻译,不是作者原文。 保留原文组件编号、Fig.2 与引文 [48],仅清理 PDF 提取产生的标点空白。
原权利人保留版权;CVF Open Access 未声明 CC BY。本指南仅作署名教学短引,不重新发布全文或原图,不向第三方转授原论文版权。
结构模板
方法概述模板
To address [Intro challenge], we [key design] rather than [verified prior approach]
to [specific intended capability].
In \textbf{[Problem Formulation]}
(\S\ref{sec:problem}), we define [input] and [required output].
Following this definition, in \textbf{[Input Construction]}
(\S\ref{sec:inputs}), we construct [inputs] from [verified source].
Using [constructed inputs], in \textbf{[Processing]}
(\S\ref{sec:processing}), we [operation] to obtain [intermediate output].
Given [intermediate output], in \textbf{[Output Generation]}
(\S\ref{sec:output}), we [operation] and produce [final output].
Figure~\ref{fig:framework} summarizes this workflow.3.7 实验
用对照检验贡献,解释主要差异与发现。
本节原则
- 先把 Intro 的核心主张变成可检验的问题,再安排主结果、消融和必要的扩展实验。RQ 是组织工具,不必每表编号。
- 诊断分析可按证据层级推进:先讲整体发现,再用 However 点明整体结果掩盖的局部差异,最后用 Separately 或 Next 引出独立条件分析。各层只回答自己实际检验的问题,不给没有这类分析的论文硬套标题。
- 铁律 指标交代真实定义、方向、单位、分母、汇总及无效输出处理;基线说明真实路线与版本,比较口径不能混用。
- 铁律 写清会改变结果的条件:数据版本与划分、参数值、训练或推理预算、评价方式,以及可获知的相关硬件条件。正文、附录及发布配置对应同一执行版;改了 prompt 或判据,不能把旧分数算成新版结果。
- 设置可按 Metrics、Baselines、Implementation Details 排列。结果段建议先加粗一句具体发现,再给关键对照与意义,接回 Intro 的问题,不逐行读表。
- 铁律 判断单个因素的独立作用时,固定其他条件;多因素共同变化,只能评价整套改动,不能把收益归给其中一项。
- 铁律 声称效率或稳定性时,给出相应测量与口径。效率计入所声称系统的完整成本,稳定性对应真实重复变化;重要代价和负结果不能省略。
- 实验章首承接方法或数据构建,概述真实被测对象与主发现,再用 Specifically 或自然钩子展开具体分析。名单、设置与分析拆成完整短句。
- 铁律 主张必须有对应证据。整套方法的结果不能证明未经检验的模块各自有效,不强制每项设计都单独做一次消融。
- 铁律 报告实际重复次数和重复单位,说明均值旁是 SD、SE 还是 CI。模型、案例与随机种子不能混作同一统计单位;排名高低不等于显著差异。
- 铁律 核对实际有效覆盖,再说明完整评估集合或有效子集,不预设必须删到共同子集。实际使用共同有效子集时,写清纳入条件、n of N 与排除原因;缺失、无效与不适用分开,不能只留成功输出。
- 铁律 实测案例与示意案例分开,说明选例依据。个例用于解释过程,不证明总体排名或部署效果;被测模型得分高,也不能证明 benchmark 更好。
- 铁律 全局失败组成、某场景发生率与条件子集表现分别给对象和分母;不能将不同分母的比例直接相减,也不能用局部失败诊断冒充整体差距的因果解释。
- 铁律 区分初始判分、人工复核标签与最终得分。一致性写清比较对象、范围与分母;标签一致率不等于独立准确率,也不能证明没有偏差。
- 铁律 Metrics 用一个紧凑自然段:先说明指标类别和适用对象,再按 1) 加粗指标名、2) 加粗指标名逐项定义;Models 或 Baselines 另写。每项交代定义、方向、单位、分母和汇总,不把指标分成零散无编号小节。
- 已有初始与复核记录时,可分析标签修改方向、模型分布和得分或排名敏感性。协议约束不等于已测得去偏效果,未测试的偏差不写成已证明。
- 评价器的准确标识、参数和输出限制集中放在一个可定位的设置块;正文给必要角色与引用,不反复复制全部配置。实际材料与判分版本必须对应。
实验写作模板
按实验目的选模板,删去不适用段落。设置说明怎样比较;结果先给实际发现,再给关键对照、图表证据、解释与范围。每个模板接回引言中的同一个问题。
实验章概述
实验章开头需要说明研究问题和证据安排时。正文已经清楚时,不再加空泛总领段。
问题与证据安排
To answer [引言中的研究问题], we evaluate [研究对象] under [关键比较条件]. The main comparison tests [整体能力或主要主张]. Controlled variants examine [核心设计的作用], while [分析类型] investigates [需要解释的现象]. Together, these tests assess [本文要回答的具体问题] within [实际测试范围].
概述检验任务与顺序,不预告尚未成立的优势。只保留本论文实际开展的主结果、对照和分析;小节名称与后文一致。
实验设置
读者需要复现比较,或判断结果是否可比时。训练、人工评估等条件只在适用时填写。
Data and splits.
We evaluate [研究对象] on [数据与版本], using [训练、开发和测试划分,或无训练任务的评测集合]. Splits are separated by [划分单位], and [重复记录或泄漏控制] prevents [具体泄漏路径]. The evaluation includes [样本数量及统计单位], with [排除规则、缺失情况和有效子集] reported in [位置].
没有训练就删掉训练划分,不创造数据分割。说明划分是按样本、用户、场景、时间还是其他单位;独立验证与开发集比较分开。
Metrics.
We measure [评价目标] using [指标全称及来源], where [指标定义与方向]. Scores are aggregated over [统计单位] using [平均、加权或其他汇总规则]. For [比例指标], the denominator is [分母及有效条件]. We report [实际重复次数与不确定性方法] over [种子、案例、用户或其他变动来源].
区分案例、回答、判据和用户等统计单位。区间与标准差必须说明对应的重复或重采样单位;只有单次结果时如实写,不能填假误差条。
Baselines.
We compare [本文方法或被测对象] with [最相关对照及引用], using [官方实现、复现或引用结果及版本]. All directly comparable runs share [输入信息、数据划分、评价协议与资源条件]. [必要适配] converts [输出形式] to [评价形式]. Results from [不同协议或原论文] are reported separately because [可比性差异].
只有实际相同时才填共享条件。被测模型得分高不等于基准设计更好;引用分数与重跑结果分开,接口版本和必要适配不能省略。
Implementation.
We implement [方法或运行流程] with [代码、模型与软件版本]. [训练或调参方法] uses [开发数据与选择规则], with [关键超参数、搜索范围及最终设置] fixed before [测试阶段]. Runs use [硬件或API配置], [推理、采样及重试规则], and [资源预算]. [完整配置、提示词或复现细节] are provided in [位置].
填会改变结果的真实设置,包括优化器、学习率、解码、调用预算和重试;不适用项删除。不能把测试集用于选参后仍称独立测试。
Human or model-based evaluation.
For [需要人工或模型判断的指标], [评估者及资质,或judge模型及版本] evaluate [评估样本及统计单位] using [评分规则]. We use [盲评、随机化或其他偏差控制] and aggregate ratings by [汇总规则]. [实际一致性核验] covers [核验子集及抽样方式]; this check supports [已核验的范围].
这段仅在有主观评估时使用。披露judge是否与被测模型相同、人工核验子集与分母;子集一致性不能当作全部评测准确率。
主结果
报告整体能力、方法差异或主要研究发现。结论可为改善、差异、无明确支持或失败,不预设胜出。
结论、关键比较与范围
For [引言中的研究目标或测试条件], [一条自明的实际结论]. Table [主结果表] compares [关键对象] under [可比条件] using [对应指标]. [决定结论的比较或差异] supports this finding, with [必要数值、统计单位或不确定性]. This pattern indicates [证据支持的含义] for [引言中的具体问题], while [尚未检验的条件或不同结果] limits the conclusion to [实际范围].
一段绑定一张主要图表,不逐格读表。只保留影响结论的数字;没有检验不写显著,没有对应对照不写原因,没有部署研究不写已提升部署可靠性。
设计检验与消融
需要判断某项设计是否发挥作用,而不是只比较整套系统。替换、删除、增加或其他受控变体都可使用。
受控变体与设计作用
Under [固定条件], [设计或变体] shows [关于原动机的一条实际结果]. To test whether [具体设计] addresses [引言中的同名局限], we compare [完整配置] with [明确删除、替换或改变的配置]. Both variants retain [其他输入、训练、评价与预算条件]. Table [消融表] shows [关键变化及不确定性], supporting [该对照能支持的设计作用]. [仍有耦合因素或未覆盖条件] leaves [不能区分的问题] unresolved.
写清改了什么、其余保留什么、结果怎样、能说明什么。删除模块同时改变参数量或预算时披露差异;整套系统更好不能自动归功于单一模块。
敏感性与资源预算
主张依赖阈值、输入规模或资源投入,或需要说明效果与成本的关系时。只选实际做过的段落。
参数或条件敏感性
For [对应研究目标], [指标] shows [实际趋势或不稳定现象] as [参数或条件] varies. Figure [敏感性图] varies [唯一改变因素及范围] while holding [其余条件] fixed. [关键区间或变化] identifies [观察到的适用范围], with [重复方式与不确定性] reported for each setting. This result supports [原设计动机中已检验的部分], but does not establish [测试范围外的性质].
不是所有参数都要扫一遍。说明选参数据与测试数据;试过的区间不能外推为普遍鲁棒,趋势也不等于机制。
效果与资源代价
At [共同预算或比较口径], [实际效果与代价关系]. Table [资源表] reports [质量指标] alongside [耗时、内存、调用量、token或其他成本], measured on [硬件、API或运行条件] over [统计单位与重复方式]. [关键比较] characterizes the trade-off between [收益] and [代价]. The measured cost covers [计入环节], excluding [未计入但相关的环节].
比较端到端耗时还是单步耗时须写清;训练、调参、离线处理和在线推理分别核算。API价格只说明实测时间与计费条件,不把局部加速写成端到端节省。
错误分析与解释检验
需要说明错误集中在哪里、可能怎样产生,或区分竞争解释时。描述性分析和解释检验分开。
错误分布与研究问题
Within [统计范围], [错误或差异] concentrates in [实际条件]. To examine [引言中的具体困难], Figure [分析图] groups [统计单位] by [分组标准] and reports [错误定义、分母与实际差异]. [代表性现象或关键分组对照] indicates [观察支持的含义]. This association is consistent with [可能解释], but [未控制因素或覆盖限制] prevents attributing the pattern solely to [候选原因].
分组口径与Intro问题一致;展示成功和失败的选择规则不能藏。定性例子说明现象,频率结论仍需分母,相关不写因果。
区分竞争解释
Under [受控检验条件], [候选解释之间可判断的实际结论]. To distinguish [解释A] from [解释B], we change [可区分预测的干预或对照] while preserving [必要控制条件]. Table [解释检验表] shows [关键证据], which supports [该检验支持的解释范围]. [仍无法排除的解释或适用条件] limits what this test establishes about [原动机对应的机制].
只有真的做过可区分检验才用这段;没有时保留上一段的可能解释,不造机制实验。
指标定义
教学改写;示例方法与实验设置仅用于说明写法,不是已发表论文原文或实测结果。
To test whether evidence notes improve citation support1, we evaluate multi-turn questions about static English manuals. Human raters check each factual answer sentence2 against its cited passage using a shared rule. A sentence without a citation counts as unsupported.3 For each question, citation support is the fraction of factual sentences supported by their cited evidence; higher is better. We average these per-question fractions rather than pooling sentences across questions.4 Answers with no factual sentences are reported separately as not applicable5, together with their count.
为检验证据笔记能否提高引用支持率1,我们评价针对静态英语手册的多轮问题。指标。人工按同一规则检查每句事实2能否由所引片段支持。没有引用的句子按不支持计。3对每个问题,引用支持率是获所引证据支持的事实句比例,越高越好。我们对各问题的比例取平均,不把所有问题的事实句混在一起计算。4没有事实句的回答单列为不适用5,并报告数量。
StarPaper · 教学改写
出处与复用范围
独立教学示例,使用静态手册问答说明组织方式,不对应私有项目。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
主结果
假设主结果段;比较与结果方向仅用于教学,实际须填核验后的差值、表号及统计范围。
Evidence notes improve citation support under a fixed evidence-context budget.1 In the comparison in Table [main], the note-based system has higher support than direct passage retrieval when the language model, decoding settings, and evidence-context token budget are held fixed2. The contrast supports note-guided generation as a whole3; separate ablations are needed to distinguish quote organization from constraint retention. However, the note builder adds processing time4, so the quality gain must be considered together with end-to-end latency.
在证据上下文预算固定时,证据笔记提高了引用支持率。1在表[主结果]所示的对照中,固定语言模型、解码设置和证据上下文词元预算后2,笔记系统的支持率高于直接片段检索。这一对照支持该设置下的笔记引导生成整体3;区分摘句组织与约束保留的作用,还需要分别消融。不过,笔记构建增加了处理时间4,因此质量收益需要与端到端延迟一起考虑。
StarPaper · 教学改写
出处与复用范围
独立教学示例,使用静态手册问答说明组织方式,不对应私有项目。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
消融分析
教学改写;示例方法与实验设置仅用于说明写法,不是已发表论文原文或实测结果。
To examine the role of retained dialogue constraints1, we remove those constraints from the notes while keeping source quotes unchanged2. Both variants use the same language model, test questions, decoding settings, and maximum evidence-context budget3. If constraint satisfaction decreases after this single change4, the comparison supports retaining constraints in the tested setting. The comparison does not isolate the benefit of the entire note-building pipeline5, because source selection and quotation remain active in both variants.
为检验保留对话约束的作用1,我们从笔记中移除这些约束,保留来源摘句2。两种设置使用相同的语言模型、测试问题、解码设置和证据上下文预算上限3。若这项单一改动后约束满足率下降4,该比较支持在实测设置中保留约束有用。它不能单独确定整套笔记构建流程的收益5,因为两种设置都仍在进行来源选择和摘句。
StarPaper · 教学改写
出处与复用范围
独立教学示例,使用静态手册问答说明组织方式,不对应私有项目。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
组件效果
论文原文整段 · 中文为本指南翻译;高亮与旁批按颜色和编号对应。
We highlight the importance of natural footwork in enhancing visual aesthetics1 (Tseng, Castellon, and Liu 2023). As shown in Table 32, our Footwork Adaptor markedly enhances the model’s PFC value3. Moreover, when utilized independently4, it boosts the model’s GMC, underscoring the FA’s dual benefits: preventing foot slipping and augmenting dance coherence5.
我们强调自然脚步对提升视觉美感1的重要性(Tseng、Castellon 与 Liu,2023)。如表 3 所示2,Footwork Adaptor 明显改善了模型的 PFC 指标3。此外,单独使用该模块时4,它也提高了模型的 GMC,体现出 FA 的双重作用:减少脚部滑动,并增强舞蹈协调性5。
TCDiff · AAAI 2025 · §Ablation Study,Effectiveness of Footwork Adaptor,自然段;PDF p.7,proceedings p.2651;Table 3
出处与复用范围
英文保持原文,仅合并换行、还原排版断词,并移除粗体段标题;中文为本指南翻译。英文原文包含 PFC 与 GMC 的两项作用,教学批注明确各自的指标和对照,不改原句。
作者教学复用;原论文英文短引与原图不受 StarPaper 原创内容 CC BY 授权覆盖。本文不转授第三方转载原论文材料的权利。
结构模板
实验设置
\noindent\textbf{Metrics.}
We evaluate [target properties] using [verified metrics and assessment units].
1) \textbf{[Metric 1]} measures [definition, unit, direction, and denominator].
2) \textbf{[Metric 2]} measures [definition, unit, direction, and denominator].
We aggregate [per-unit results] by [actual rule] and handle [invalid or not-applicable outputs] according to [actual protocol].3.8 讨论
解释发现的意义,区分观察与机制。
本节原则
- 解释结果改变了什么认识,不再复述成绩表。
- 铁律 解释与机制分开。没有单独控制某项设计,不能把效果全部归因于它。
- 铁律 讨论沿用实测范围,未执行的方案不写成已得到的结果;决定结论的实质限制就近说明。
结果解释与局限
假设教学段落,非论文原文或实测结果。
Higher citation support is consistent with more explicit use of document evidence1. However, the current comparison changes both quote organization and the amount of constraint information provided to the generator2. The comparison therefore cannot identify which change accounts for the gain.3 Our evaluation covers static English manuals; cross-language questions and frequently updated documents remain untested4. Separate evaluations are needed because language and document updates can change which quoted evidence supports an answer5.
引用支持率提高,与更明确地使用文档证据这一解释相符1。然而,当前比较同时改变了摘句的组织方式和提供给生成器的约束信息量2。因此,这个比较不能判断哪项改变带来了收益。3当前评价覆盖静态英语手册;跨语言问题与频繁更新的文档尚未检验4。这些设置需要另行评价,因为语言与文档更新可能改变哪些摘句能够支持答案5。
StarPaper · 教学改写
出处与复用范围
沿用文档问答的假设任务,展示信息顺序与论证作用,不代表新增研究结果。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
3.9 局限性
用一个自然段写清两项与任务相关的具体边界。
本节原则
- 铁律 本套 CS 写作约定:Limitations 全节只写一个自然段,用 First, 和 Second, 引出两点,不另起段、列条目或加小标题。官方格式与当前用户要求优先。
- 铁律 每点先用 although 简短说明已完成的有据工作,再给具体的特殊或长期边界;已有措施不能写成解决了尚未验证的问题。
- 作者行动用 we;贡献和实现细节简写,重点放在仍需讨论的具体对象及其与本文任务的关系。
- 依据实际覆盖选择长尾需求、长期反馈或其他相关边界。不机械复用上一论文的主题,也不泛泛说未来增加数据。
- 铁律 未测试不等于已失败。未来场景只作研究方向示例,不冒充已发现的缺漏、数据事实或实测结论。
- 铁律 真实有效性限制与全文结论一致;若限制动摇核心结论,先缩小或修正结论,不用让步句掩盖。
局限性:已完成工作与具体边界
通用教学模板,非真实论文原文或实测结果。
First, although we have [verified work addressing the main difficulty]1, [specific special condition] still warrants further study.2 Second, although we have [another verified contribution]3, [specific longer-term condition] still warrants further study.4
首先,尽管我们已完成[针对主要难点的有据工作]1,[具体特殊情况]仍值得进一步研究。2其次,尽管我们已完成[另一项有据工作]3,[具体长期情况]仍值得进一步研究。4
StarPaper · 教学改写
出处与复用范围
只展示单段 First/Second 让步结构;方括号根据本稿材料填写。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
结构模板
Limitations:单段两点
First, although we have [verified work addressing the main difficulty], [specific special condition] still warrants further study. Second, although we have [another verified contribution], [specific longer-term condition] still warrants further study.
3.10 结论
回答开头的问题,概括贡献和发现。
本节原则
- 可按“回答 Intro 问题、概括对应设计、关键发现与范围”收束;不只重复方法流程。
- 铁律 只收束正文已建立的认识,不新增结果、对照或能力;名称、结论方向与范围和正文一致。
- 保留关键取舍和适用范围。未来方向接实际局限,不重复整套方法流程。
结论结构
公开预印本原文段落 · 中文为本指南翻译
We present EviNote-RAG, a framework that introduces a note-taking step to extract answer-supportive evidence before answering1. By training LLMs to produce Supportive-Evidence Notes (SENs) and guiding them via a tailored entailment-based reward2, our approach improves answer accuracy. Extensive experiments demonstrate that EviNote-RAG achieves state-of-the-art performance while enhancing training stability3.
我们提出 EviNote-RAG,在回答前加入笔记步骤,提取能够支持答案的证据1。通过训练 LLM 生成能够支持答案的证据笔记(SENs),并用专门设计的蕴含奖励引导模型2,方法提高了答案准确率。大量实验表明,EviNote-RAG 达到当前最优表现,同时改善了训练稳定性3。
EviNote-RAG · arXiv v3 公开预印本 · § 5 Conclusion,第一自然段(三句);arXiv:2509.00877v3,2025-10-16;公开 HTML #S5。
出处与复用范围
摘录公开 arXiv v3 的 Conclusion 第一自然段,英文词句未改;中文翻译、高亮与旁批为本指南添加。
公开 arXiv v3 采用 non-exclusive distribution,原文版权由权利人保留。作者教学短引,不随本指南转授全文再版许可;中文翻译与分析为本指南新增。
3.11 参考文献
引用回查原文,信息和版本对齐。
本节原则
- 铁律 引用支持附近的具体判断,先回查原文,不把搜索摘要或能编译的 BibTeX 当核验。
- 模型、数据、工具和外部方法首次实质出现时,可就近引原始报告或官方文档,方便查证;实际出处与归属必须准确。
- 铁律 条目对应实际版本,核对题名、作者、年份、原始或正式日期及预印本身份。同一论文的重复版本去重;访问日期与版本更新日期不当作新论文日期。
- 铁律 来源没测过的条件,不能用它支撑该条件下的结论。没有真实来源就缩小或删除说法。
- 铁律 直接引用的文字与借用的图注明出处,另核对转载或使用许可。公开可读不等于可以直接复用,学术用途也不自动证明已获授权。
引用与主张
教学段落;方括号为来源与版本占位,不是假造文献条目。
Retrieval-augmented generation combines retrieved passages with answer generation [primary method paper]1. A study evaluated only on single-turn questions cannot establish performance on changing multi-turn constraints.2 We use [retriever and version] [official documentation for that version]3 to retrieve candidate passages. The method citation supports the approach; the version-specific documentation identifies the tool actually used.4
检索增强生成将检索到的段落与答案生成结合起来[原始方法论文]1。只在单轮问题上评价的研究,不能证明方法能够处理多轮对话中变化的约束。2我们使用[检索器与版本][该版本的官方文档]3检索候选段落。方法引用说明采用哪条路线;对应版本的文档说明实际使用什么工具。4
StarPaper · 教学改写
出处与复用范围
用占位展示正文主张与真实来源的对应,不提供虚构作者、年份、题名或 DOI。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
3.12 附录
提供可定位、可复核的设置与补充材料。
本节原则
- 铁律 正文保留独立成立所需的核心设计、关键证据与决定结论的限制,不能全移附录。整理时可先删重复,再移次要细节。
- 技术细节、实验设置、补充结果分节,每节开头说明服务哪项主张;正文在对应位置引用具体节、图或表,避免读者在附录里查找。
- 铁律 附录中的参数、prompt、数据与评分规则对应实际运行版,符号和统计范围与正文一致。后加规则不能写成实验已用。
- 铁律 补充结果改变主结论时,同步改正文、摘要和引言;不能把相反证据只留在附录。
- 铁律 图表移到附录时,同时移动详解,修正 Overview 和引用;正文保留主要结论。名称更新不改变冻结 prompt、机器字段或分析结果;显示改写不能冒称执行原文。
附录组织
假设教学段落,非论文原文或实测结果。
To reproduce the citation-support comparison in Section [X]1, this appendix records the prompts, document versions, retrieval settings, and scoring rules for both systems2. Each run is linked to the corresponding configuration and retains failed outputs. We select the maximum note length using development questions and freeze it before evaluating the test questions3. Per-run scores and uncertainty estimates are reported in Table [Y], so the aggregate in the main text can be traced to the same runs4.
为复现第[X]节的引用支持率比较1,本附录记录两个系统的2提示词、文档版本、检索设置与评分规则。每次运行都关联对应配置,并保留失败输出。我们用开发集问题选择笔记最大长度,在评价测试问题前冻结这个选择3。表[Y]报告各次运行得分与不确定性估计,使正文的汇总结果能追溯到同一批运行4。
StarPaper · 教学改写
出处与复用范围
沿用文档问答的假设任务,展示信息顺序与论证作用,不代表新增研究结果。
本指南原创内容采用 CC BY 4.0;转载请附作者、原文链接与许可,改写注明改动。
没有找到。少选一个条件,或换个短词试试。
4. 辅助工具
按用途选。以下整理自公开文档,未逐项安装;版本和许可见原项目。
4.1 文献检索与阅读 · 4.2 写作与排版 · 4.3 论文绘图 · 4.4 引用核验 · 4.5 代码阅读 · 4.6 论文发布与维护 · 4.7 其他资源 · 4.8 开源整理
4.1 文献检索与阅读
AI-Powered Literature Review Skills:检索、去重、逐篇分析,再组织综述。
README 的验证阶段包含基础元数据检查,不能替代全文核验;检索还取决于数据库访问权限和浏览器环境。
沉浸式翻译:网页和 PDF 双语对照。
术语、否定和统计结论可能误译,关键内容回原文核对。安装和账户要求看官方文档。
Zotero 中文社区插件目录:按任务和 Zotero 版本找插件。
社区目录与 Zotero 官方无从属关系;排行榜不是兼容性或安全审计。
Better Notes:整理批注、连接笔记、导出 Markdown。
Markdown 自动同步是双向的;启用前确认需要同步的文件,保留原始批注。
Zotero PDF2zh:在 Zotero 内翻译 PDF,原文与译文对照。
需要插件与翻译服务配合;译文只辅助阅读,关键结论仍回原文核对。
Zotero MCP:让 AI 搜索 Zotero 文献、全文和笔记。
插件也有写入笔记、标签和元数据的功能;需要只读时明确限制操作。连接云端 AI 后,读取内容可能发给模型服务商。
4.2 写作与排版
ChineseResearchLaTeX:中文科研 LaTeX 模板:标书、论文、学位论文、简历。
模板先与当年的学校、基金或期刊官方要求对照;项目说明要求使用 XeLaTeX。
THU-PPT-Theme:PPTX 模板,统一答辩或组会排版。
采用 CC BY-NC-SA 4.0,保留署名、遵守非商业与相同方式共享条件;校徽等标识另按其规则使用。
4.3 论文绘图
Paper Plot Skills:用自己的数据画统计图,参考图布局转 matplotlib。
参考图用于借鉴表达;不要把复现图当成自己的实验结果。仓库首页未明确展示许可证,复制代码或原图前另查授权。
Paper Framework Figure Studio Pro:核对模块与箭头,分轮生成框架图。
当前主线主要面向 ChatGPT 网页端;默认交付候选参考图,可编辑 SVG 或 PPT 通常还需另行重绘。
Lieflat Charts:数据转交互 HTML 图表或一页报告。
项目采用非商业许可;商业使用需另行取得许可。图表工具不会替你验证输入数据。
4.4 引用核验
Scholar Ref Cleaner:BibTeX、Word、文本引用与数据库元数据比对。
查无结果可能来自数据库覆盖或网络问题,不能直接判为伪造;元数据匹配也不证明引用支持正文论断。
TrueCite:上传 BibTeX,筛出需复核的引用。
页面当前说明只支持 .bib,最大 1 MB;自动标记不是学术不端判定,核查正文论断仍需读原文。
ValiRef:从 PDF 提取引用,检索来源,生成核验报告。
ruanyf/weekly 的链接是开发者自荐,不是独立评测;LLM 报告可能误判,项目的准确率主张未在这里复测。
DrClaw · Check Review Alignment:核对引用是否支持正文,记录原句、证据和位置。
核对已有引用与正文论断的对应关系;不能保证自动核验无误。排版导出另依赖项目里的综述 skill。
4.5 代码阅读
4.6 论文发布与维护
Hugging Face Daily Papers 投稿:将公开 arXiv 论文提交到 Daily Papers。
论文被索引、作者认领、进入 Daily Papers 是不同状态;当前资格与时间窗口以投稿页面为准。
Hugging Face 作者认领:在 Paper Page 点击自己的名字,认领署名并等待验证。
只认领自己署名的论文;把公开论文页用于分享,个人认领流程留在账号内。
Hugging Face Daily Papers 历史页面:按日期看论文,检查自己的公开论文页。
出现在日期页不代表会议接收、同行评审或结果复现;该链接是历史示例。
4.7 其他资源
Edit Banana:静态图转可编辑 DrawIO 元素。
项目说明线上服务与仓库功能可能不同。README 写 Apache 2.0,LICENSE 文件实际为 AGPL-3.0;复用或部署前先确认许可。
PDF Cut White:裁剪 PDF 图表白边,另存新文件。
README 说明默认只处理 PDF 第一页;保留原件,并为输出使用不同文件或目录。仓库首页未明确展示许可证,复制代码前另查授权。
科研 Skills 社区介绍 · 卡尔的AI沃茨:科研 skill 社区介绍;找候选后回项目原文。
作者的体验与排名是社区观点,不是统一条件下的基准测试,也不替项目做许可或安全保证。
没有匹配的工具。换个短词试试。
4.8 开源整理
先写清允许处理的文件。中文界面、接口字符串、业务路径也可能影响运行,不能一键全换。填写允许修改的范围后再使用。
中文提示词
只处理我指定的文件:<文件或目录>。
把中文注释、文档字符串和使用说明译成英文,保留解释代码所需的注释,删除版本更改流水账。把注释和文档中的个人信息、内部地址、机器绝对路径改成通用说明、相对路径和可运行的例子。保留必要的作者署名、引用与许可证信息。
保持算法、控制流程、变量名、接口、参数和数据不变。不要自行翻译程序输出、异常消息、协议字段或其他可执行字符串;若文档字符串被程序读取,也先报告影响。
疑似密钥、私有数据或运行时配置不要贴出原值。列出文件位置和处理建议;若替换会影响行为,先停在该处,说明需要什么决定。去秘检查也覆盖计划发布的样例、配置、日志和压缩包;若还发布 Git 历史,另查历史内容。
示例:文档中的机器路径改为 data/example.json,并说明从项目入口定位;只改说明,不改程序的路径解析逻辑。密钥示例使用 YOUR_API_KEY,不写真实值。
交付修改差异、处理过的内容类型、未解决项和实际验证结果。没有跑过的检查不要说通过;发现真实秘密时不要发布,先报告位置和处置需求。依据:minimal-code-layout · 作者指定的翻译与去秘范围 · 对应铁律与完整提示词
文档核对:2026-10-07。安装、版本和许可见项目原文。
参考阅读
写作指南、会议要求和示例论文。摘录与图片附出处、版本和许可。
- Mensh & Kording (2017) · Ten simple rules for structuring papers — 中心贡献、读者视角与文章/段落结构;写法需要按研究取舍。
- Rougier et al. (2014) · Ten Simple Rules for Better Figures — 根据读者与主要信息选择图型,检查布局、颜色及说明。
- Henderson & Chambers (2022) · Ten simple rules for writing a Registered Report — 研究问题、适用时的假设与预先规划;不要求所有论文写 RQ1/H1。
- NeurIPS · Paper Checklist — 主张、限制、设置、统计不确定性与复现;提交时以当年指南为准。
- ACL Rolling Review · Responsible NLP Research — NLP 研究责任与披露要求;其他领域检查自己的投稿政策。
- Liu et al. (2024) · Lost in the Middle, Figure 1 / §2 — 证据位置与问答表现的控制实验,适合学习“现象—诊断”的论证。
- TCOD (2026 预印本) · Figure 1 — 多轮监督案例与课程设计并排呈现;概念图本身不证明效果。
- Reinforcing Real-world Service Agents (2026 预印本) · Figure 1 — 交互环境、轨迹、学习信号与更新对象的框架图;模拟表现不等于真实部署收益。
- NeurIPS 2026 · Main Track Handbook V2026.3,Author Responses — 2026 主会回复流程、匿名、篇幅与新结果要求;其他年份和赛道另查指南。核查日期:2026-10-07。
- ICLR 2026 · Author Guide,Discussion Stages — 2026 讨论期修订与变更说明;审稿人和 AC 不必阅读每一版。实际投稿遵循当轮最新通知。核查日期:2026-10-07。
- ACL Rolling Review · Authors Guidelines,Author response — 截至 2026-10-07 可见的作者回复指南;页面注明此版适用至 2026 年 8 月轮次,后续轮次需重查。用于了解 ARR 与直接投会议的区别,不作后续轮次规则保证。
- Yuqin Dai et al. (AAAI 2025) · Harmonious Music-driven Group Choreography with Trajectory-Controllable Diffusion — 论文作者在本指南中用少量原文短引讲解贡献、动机、方法与实验,逐项标明节名、页码和中文翻译;英文引句保持原貌,教学改写单独标注。TCDiff 的数据、性能与结论仅限论文报告的任务与比较条件。
- Yuqin Dai et al. (AAAI 2026) · Careful Queries, Credible Results: Teaching RAG Models Advanced Web Search Tools with Reinforcement Learning — AAAI 2026 正式发表;作者终稿短引,讲解问题、搜索操作、奖励、指标与消融。保留 AAAI 原版权。
- Pengyu Zeng et al. (EMNLP 2025) · CARD: Cross-modal Agent Framework for Generative and Editable Residential Design — EMNLP 2025 正式发表;模块输入输出、公平比较、人评重复与表示转换。原文 CC BY 4.0,中文为本指南翻译。
- Zeng, Dai et al. (2026 预印本) · PlanCraft: Sketch, Refine, and Furnish for Architect-Inspired Progressive 3D Residential Scene Generation — 摘录公开预印本中的短句与标题,分析渐进设计、方法总览、模块机制、结果段及 Fig.2 流程。英文、翻译和教学改写分开标注;结论限原文比较设置。
- Chaoyang Shi, Yuqin Dai et al. · UrbanZero(公开项目介绍) — 依据公开项目介绍编写双语教学示例,讲解任务编译、逐块规划与程序反馈;教学实验和模拟回复不代表论文原文或实测结果。
- Ling Shi, Yuqin Dai et al. · SAGE: An Extensible Benchmark for Service Agent Graph-guided Evaluation — 用不同短引讲解术语、指标、比较对象、相关工作、全文论证、案例版式及事实澄清;不复制私有评审材料。模拟回复明确不属于实际 rebuttal。
- Yuqin Dai et al. · EviNoteRAG: Enhancing RAG Models via Quality-Augmented Evidence Notes — 用八处不同短引讲解摘要核对、背景取舍、近邻比较、引文用途、给 AI 的真实材料、润色边界和逐点回复。数值只对应终稿表中实际比较;模拟回复并非真实评审记录。
- Pengyu Zeng et al. (CVPR Findings 2026) · GreenPlanner: Practical Floorplan Layout Generation via an Energy-Aware and Function-Feasible Generative Framework — 署名原文短引、中文翻译与写作拆解。数据合规、生成结果与不同输入设置分开;不将论文中的法规设置推广为一般建筑指导。
- Yuqin Dai et al. (IJCV 2026;引文为 arXiv v4) · TCDiff++: An End-to-end Trajectory-Controllable Diffusion Model for Harmonious Music-Driven Group Choreography — 说明模块命名、实验设置、问题与对应设计、收益与代价、未实现能力的边界;仅使用署名短引,不复制期刊原图或全文。
- Jiaqi Wang et al. · TCOD (arXiv v3) — 多轮智能体蒸馏;图2说明如何把训练诊断组织成一条论证。公开预印本,CC BY 4.0。
- Ning Gao et al. · Reinforcing Real-world Service Agents (arXiv v1) — 服务智能体的质量与成本;图2/3和附录案例用于讲解编码、动态和排版。公开预印本,CC BY 4.0。
- OneReason Technical Report · Figure 12 — 训练策略对照图;仅链接分析,不转载原图。arXiv 分发许可不等于图片复用许可。
- Bruno et al. (2024) · A universal framework for inclusive 15-minute cities — 地图、累计分布、多维气泡与设施迁移排名。原图只链接,点评为本指南整理;颜色和大小按原图注解释。
- pymoo · Pareto dominance — 多目标比较与非支配解的定义
- Callaway & Sant’Anna · Difference-in-Differences with Multiple Time Periods — DID 的比较设计与平行趋势识别条件
- Yuqin Dai et al. · EviNote-RAG: Enhancing RAG Models via Answer-Supportive Evidence Notes — Conclusion 第一自然段:核心设计、作用与结果如何收束;表现判断只对应该版本的比较。
附录:收集的参考绘图
按需要查图型。原图保留出处与许可,教学图注明模拟数据;点评同时说明值得借鉴的设计与结论边界。
动机与框架(2 张)
问题与解法对照
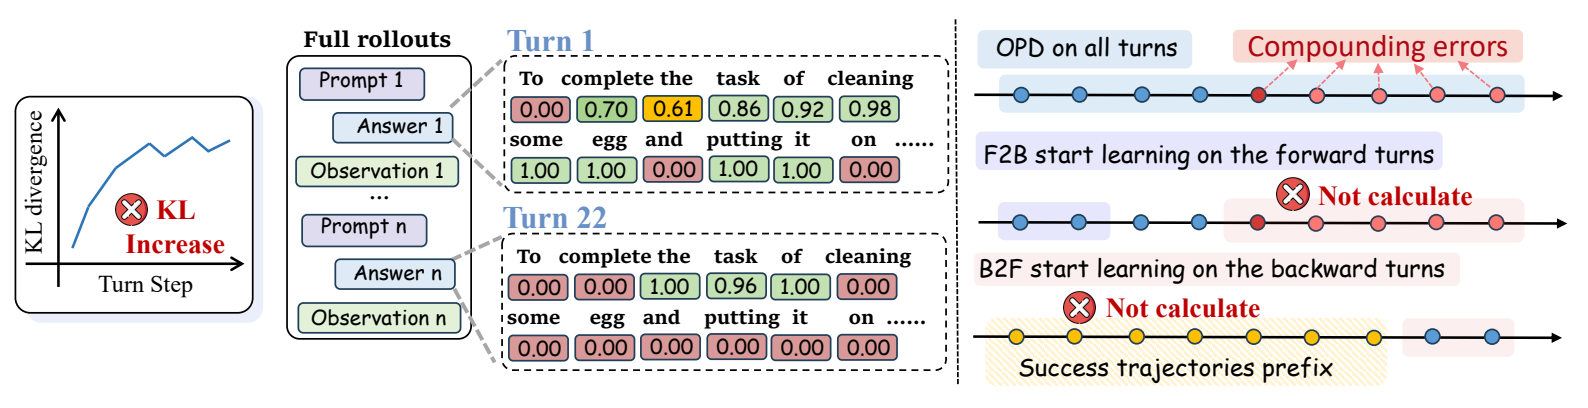
KL随轮次变化的示意先提出问题;这是示意曲线,不能当作实测结果。 从完整轨迹放大到两轮回复,文本与数值块放在一起;数值含义须由原图注定义。 三条时间线沿同一方向对照训练范围,读者直接看到改了哪一段;未计算的轮次要解释原因。
Jiaqi Wang et al., TCOD, arXiv:2604.24005v3, Fig. 1. CC BY 4.0. 从原页裁切;图形与数据未改。 · 许可
训练范围对照
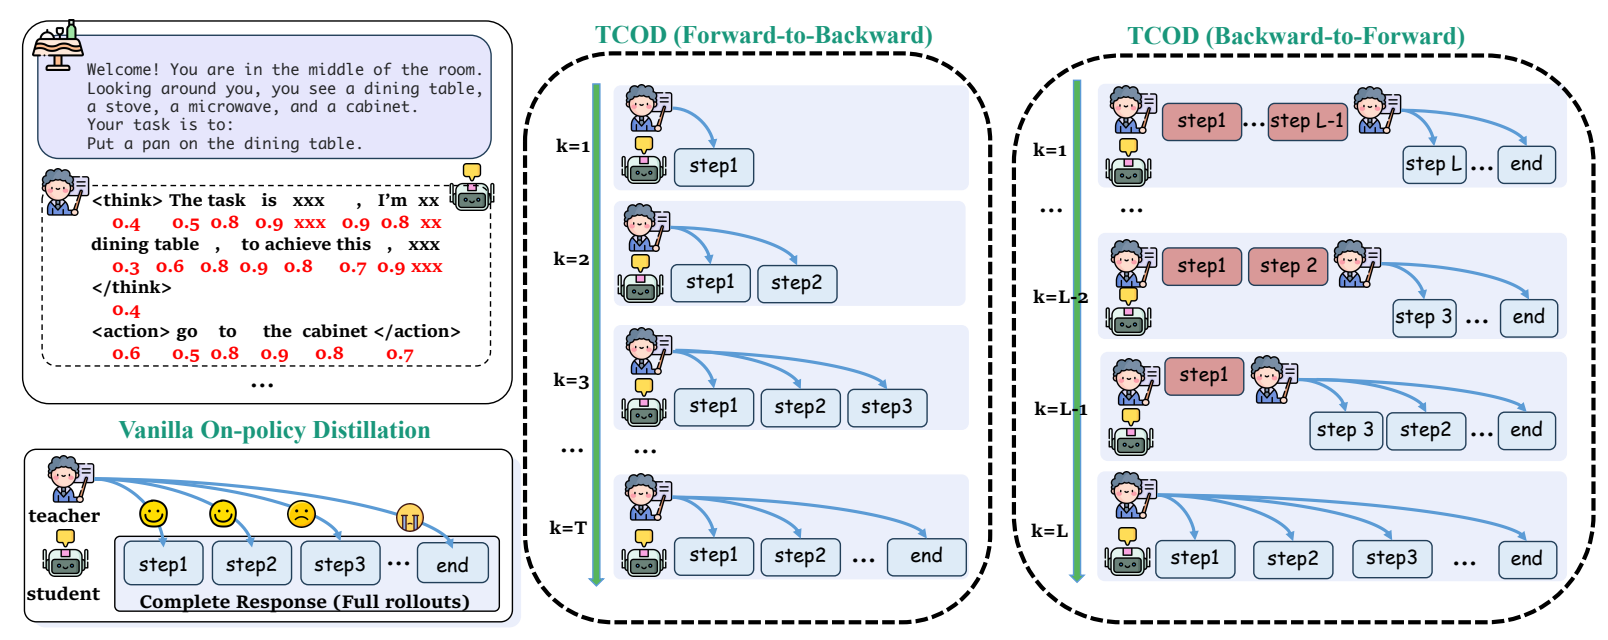
先展示完整轨迹与师生关系,为后面两种课程提供共同参照。 两种课程复用步骤框、师生图标和箭头,只改变训练覆盖位置,便于直接比较。 沿轮数向下读课程变化。步骤颜色、轮数标签和训练目标仍须在图注中定义,图标不能替代解释。
Jiaqi Wang et al., TCOD, arXiv:2604.24005v3, Fig. 3. CC BY 4.0. 从原页裁切;图形与数据未改。 · 许可
诊断与训练动态(4 张)
训练或轮次动态:折线只连有序变量;横轴写训练步数或轮次,不把无序方法连成趋势。
效果与机制曲线
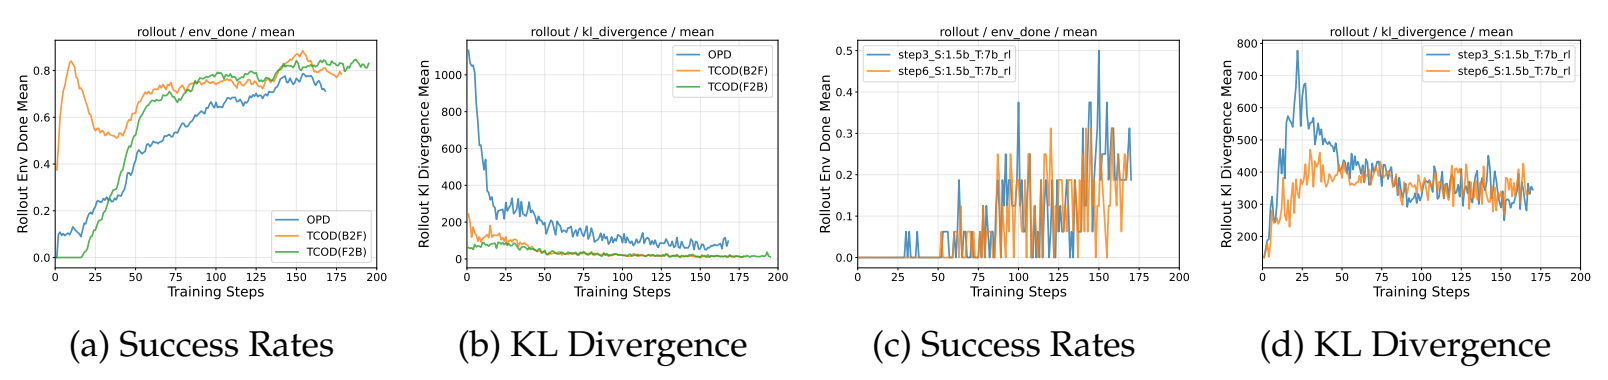
成功率与KL成对放置,效果与诊断就近对照;一起变化不等于已经证明因果。 所有面板使用训练步数,可按同一时间点比较;不同指标各用自己的纵轴。 颜色区分训练条件。原图部分图例使用日志简写,自己的论文应换成可直接识别的模型和条件。
Jiaqi Wang et al., TCOD, arXiv:2604.24005v3, Fig. 4. CC BY 4.0. 从原页裁切;图形与数据未改。 · 许可
辅助指标对照
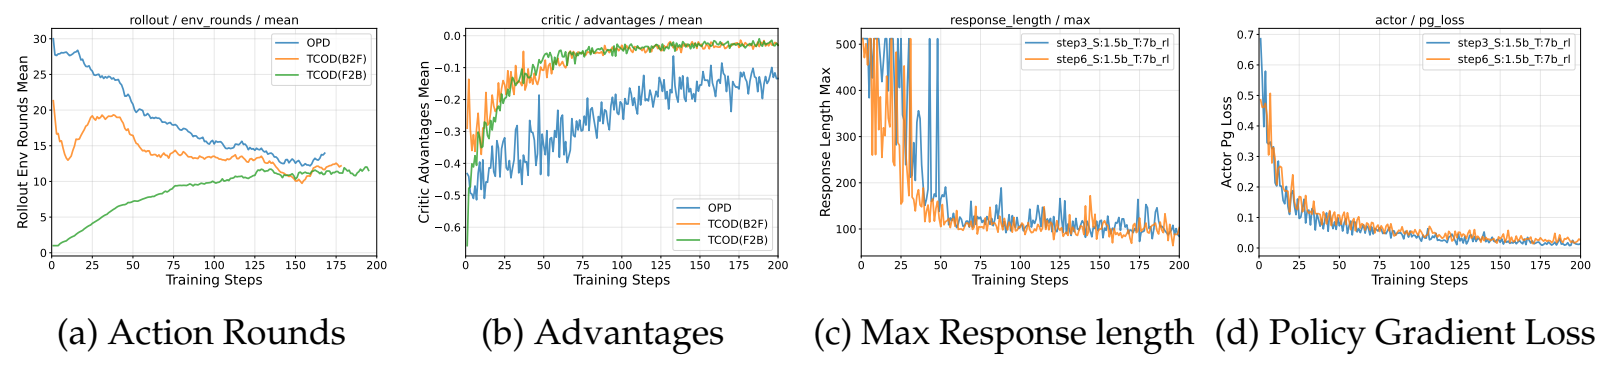
轮数、优势、最大回复长度和损失各占一格,避免不同单位挤在同一纵轴上。 横轴一致,读者可在同一训练时刻核对不同过程指标。 损失下降描述训练过程,不能替代最终任务实验;诊断指标与任务结果要分清。
Jiaqi Wang et al., TCOD, arXiv:2604.24005v3, Fig. 5. CC BY 4.0. 从原页裁切;图形与数据未改。 · 许可
多面板诊断
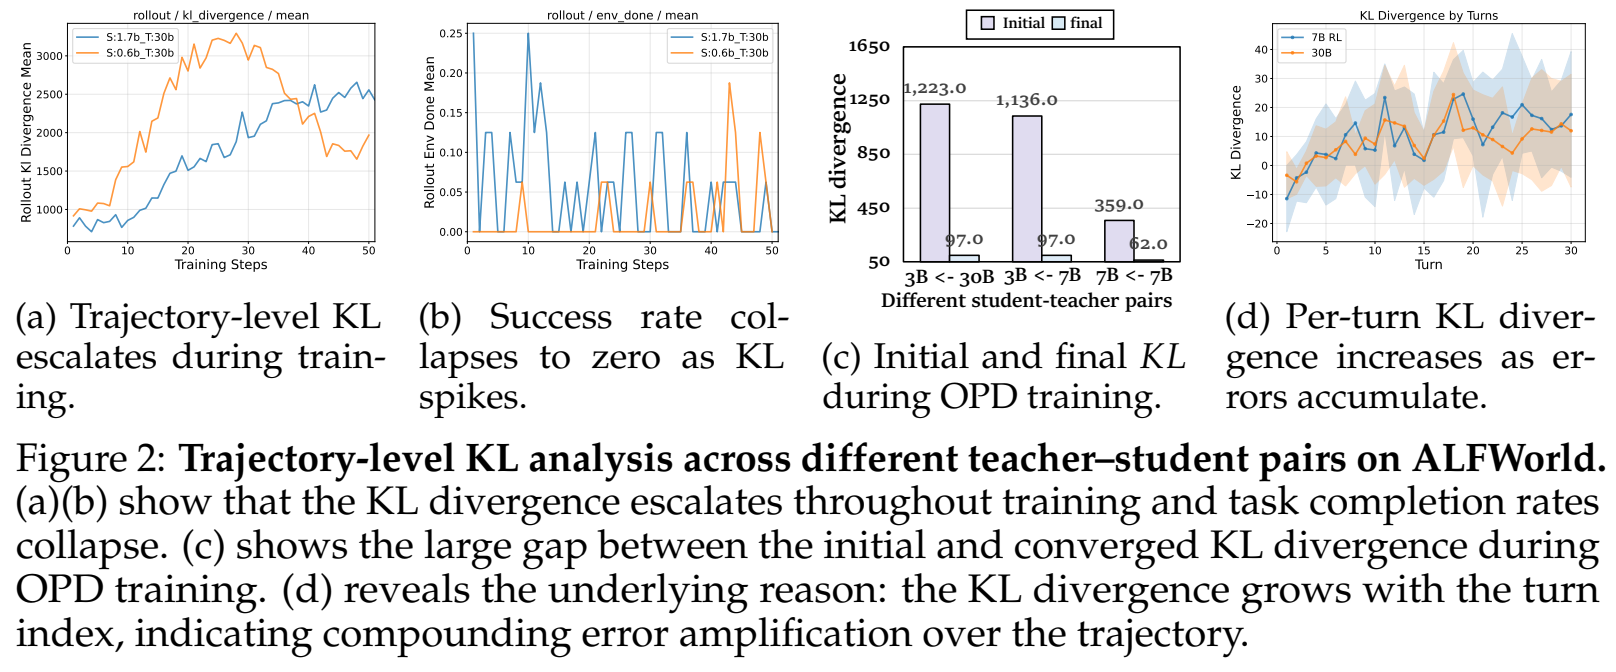
(a)(b)共用训练步数,把KL变化与成功率放在一起读;这是两种量的对照,不能仅凭曲线认定因果。 每个师生组合把Initial与final紧邻排列,横轴箭头写明配对方向,柱顶数值减少来回查轴。 纵轴从50开始,比较应读数值,不能用柱高判断初始值是最终值的多少倍。 按对话轮次展示KL,补充训练步数之外的诊断视角;色带含义应由原图注说明。
Jiaqi Wang et al. · arXiv:2604.24005v3 · Fig. 2
Jiaqi Wang et al., arXiv:2604.24005v3, Fig. 2. CC BY 4.0. 从原 PDF 裁切;图形与数据未改。 · 许可
训练动态
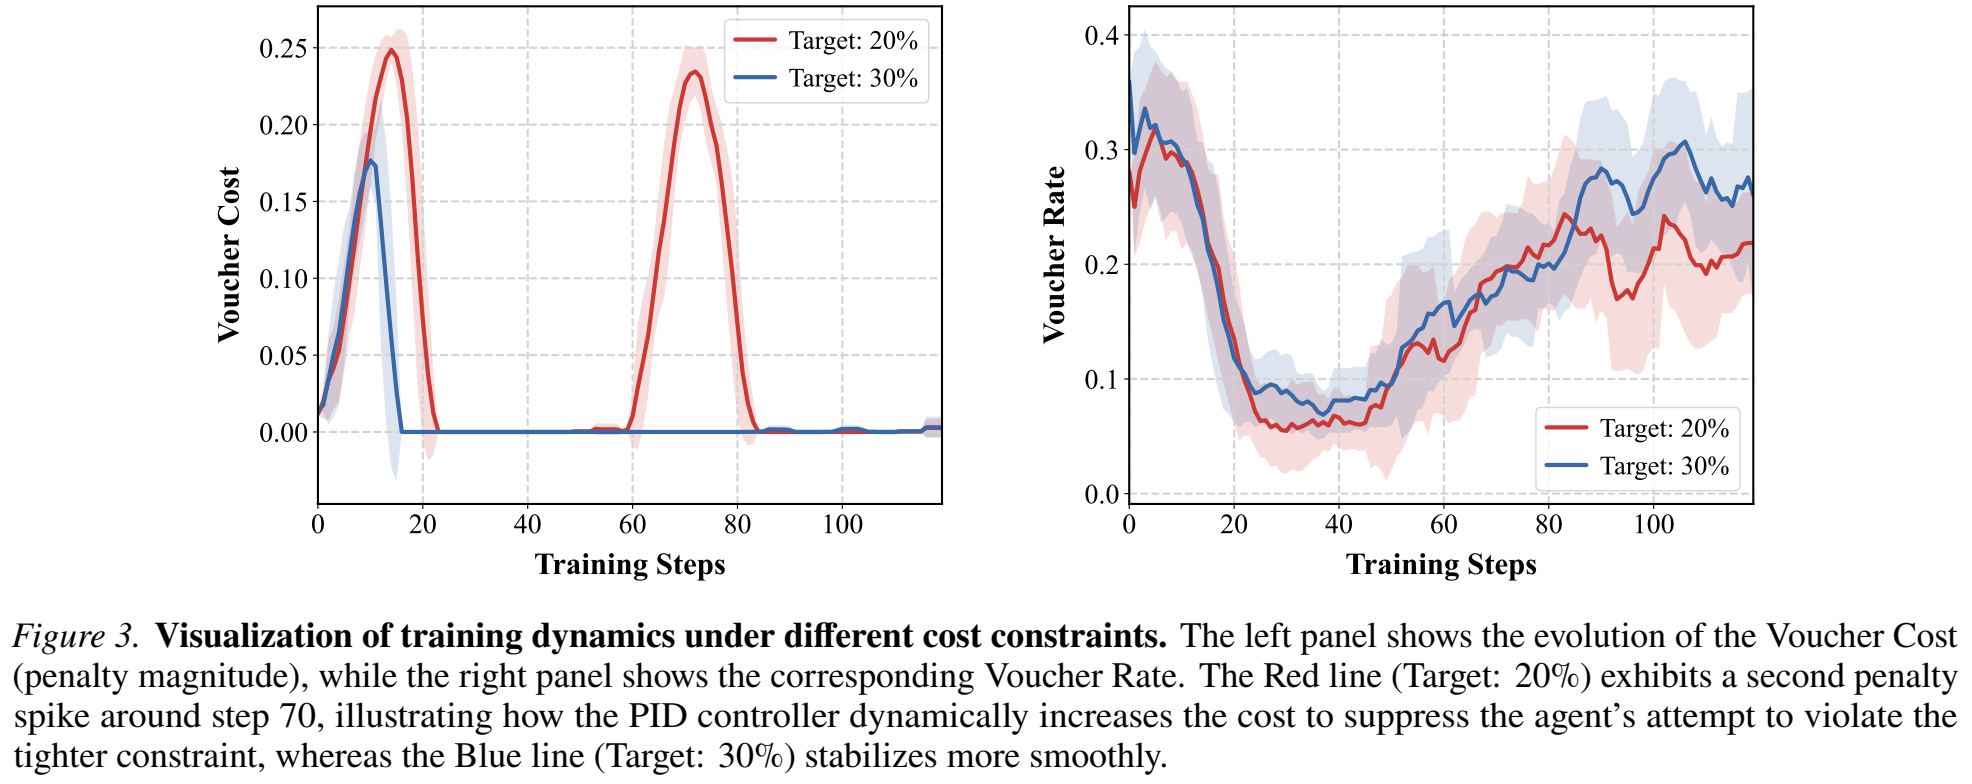
控制量与实际行为并排,共用训练步数,便于按同一时间点核对两条动态。 红蓝始终对应20%与30%两种目标,同一条件跨面板保持同色。 色带显示了额外信息,但图面未说明统计含义;不能自行补成方差、标准误或置信区间。
Ning Gao et al. · arXiv:2602.22697v1 · Fig. 3
Ning Gao et al., arXiv:2602.22697v1, Fig. 3. CC BY 4.0. 从原 PDF 裁切;图形与数据未改。 · 许可
消融与资源成本(1 张)
方法效果比较
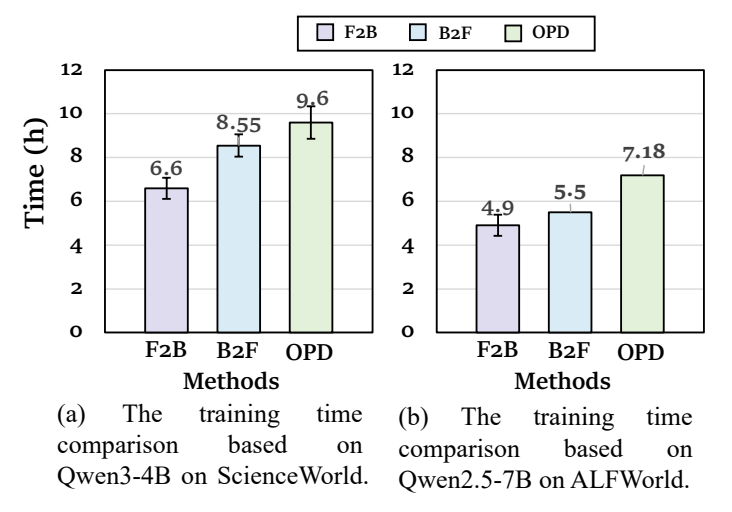
每个任务各一幅图,方法顺序一致,比较时无需重新找位置。 柱顶直接标小时数,纵轴写Time (h)。这是训练耗时,不能当作在线推理延迟;另需交代硬件与训练条件。 误差线保留,但原图未给全其含义,不能自行补成标准差、置信区间或特定重复次数。
Jiaqi Wang et al., TCOD, arXiv:2604.24005v3, Fig. 6. CC BY 4.0. 从原页裁切;图形与数据未改。 · 许可
案例(1 张)
案例图:“不同highlight颜色表示不同类型的信息” 白底保留必要背景、需求、证据、动作与结果;输入、模型输出、judge 用可解释边框,位置表示真实层级。
交互案例
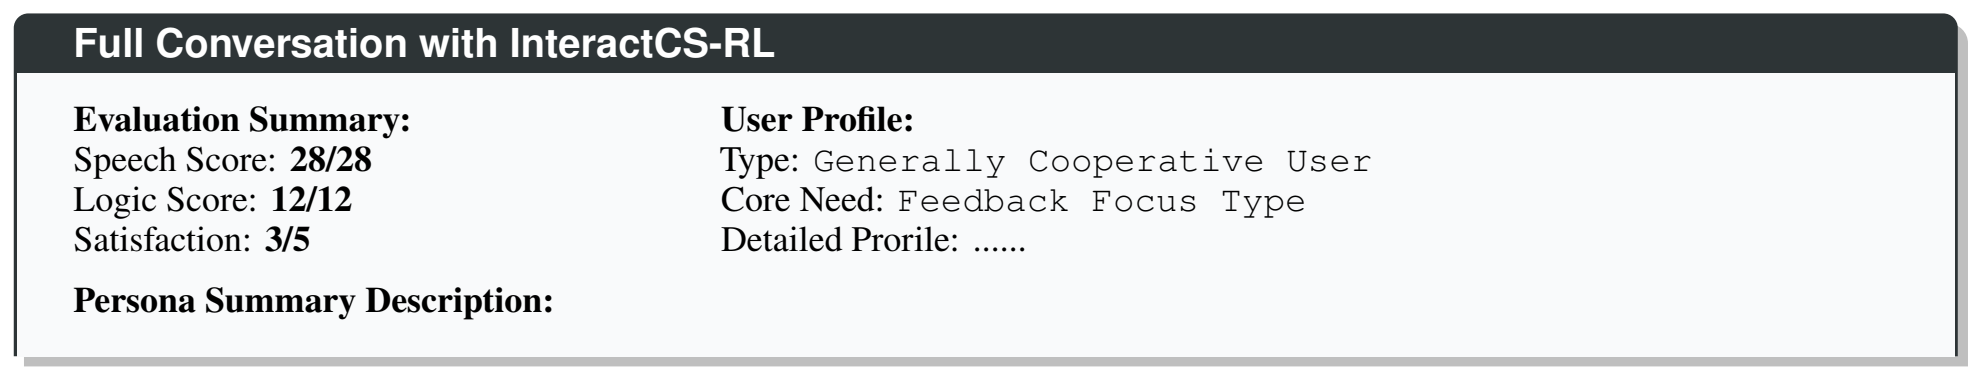
作者笔记强调像UI一样整洁:相同信息放一起,同类信息用同样的框,颜色只强调重点。 左栏是三个评价结果,右栏是用户设定;标题、字段与数值分层,不必为每个字段单独设置对话框。 字多时先分组、删重复、留白。放回双栏PDF后仍须检查字号;网页放大看清不等于论文里看清。
Ning Gao et al. · Reinforcing Real-world Service Agents (arXiv v1)
Ning Gao et al., Reinforcing Real-world Service Agents, arXiv:2602.22697v1. CC BY 4.0(https://creativecommons.org/licenses/by/4.0/)。从原 PDF 裁切;图形、标签和数据未改。
KDE 密度分布(1 张)
KDE:看分布形状:横轴是变量,纵轴是密度;颜色跟组走,均值线补位置,交代样本量和带宽。峰高不是人数,也不是累计比例。
KDE 密度分布
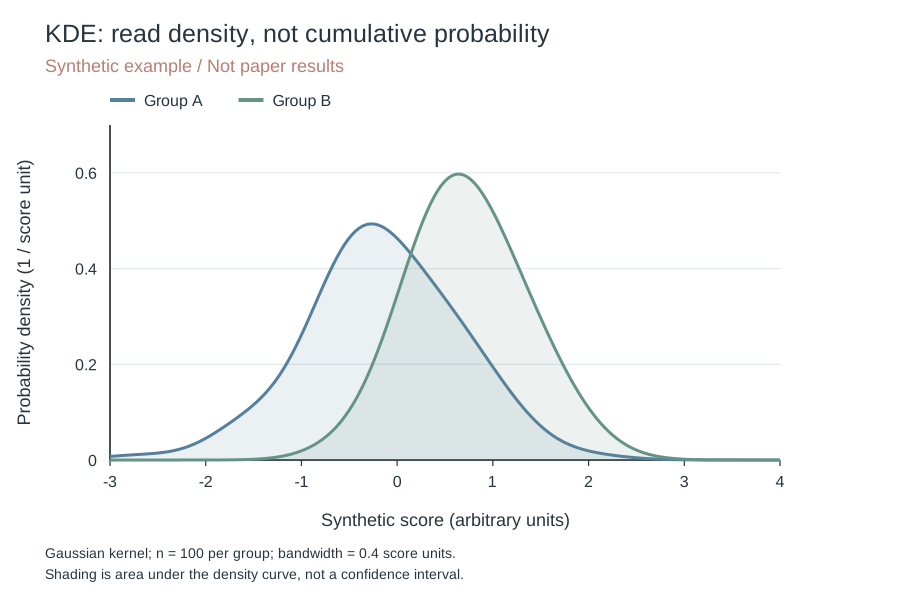
横轴是模拟分数,纵轴是概率密度;曲线越高,说明附近样本越密集,不是累计比例。 两组共用坐标,便于比较分布位置;浅色填充是曲线下面积,不是置信区间。 每组100个模拟样本,采用高斯核、固定带宽0.4;每条密度曲线的面积约为1。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
ECDF 累计分布(1 张)
ECDF:看阈值以下有多少:横轴取阈值,纵轴直接读累计比例;同一坐标比两组,阶梯从 0 到 1。低于某阈值的样本比例应从 ECDF 读取,KDE 峰值不能表示累计比例。
ECDF 累积分布
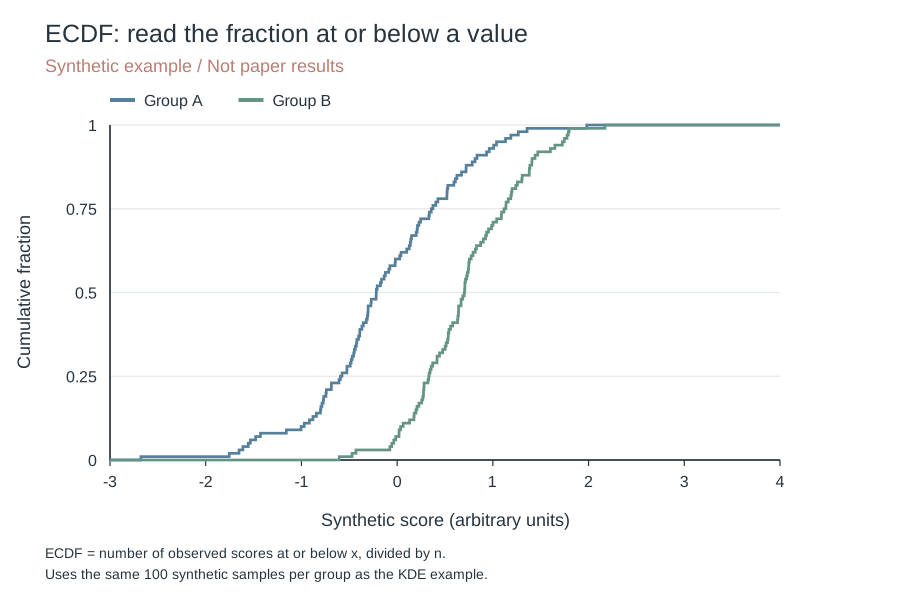
每个样本使曲线上升,纵轴表示不超过当前横轴值的样本比例。 在同一阈值比较线高,读的是累计比例差,不是该位置的样本密度。 与KDE使用同一批模拟样本,每组100个;比例直接由样本计数得到,无需平滑。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
PCA / 空间嵌入(1 张)
PCA:把高维关系投到二维:“利用空间位置关系绑定数据,更换不同的颜色呈现不同属性” 同时交代特征、标准化与解释方差。分得开不等于泛化好;PaCMAP、t-SNE 不叫 PCA。
PCA 二维投影
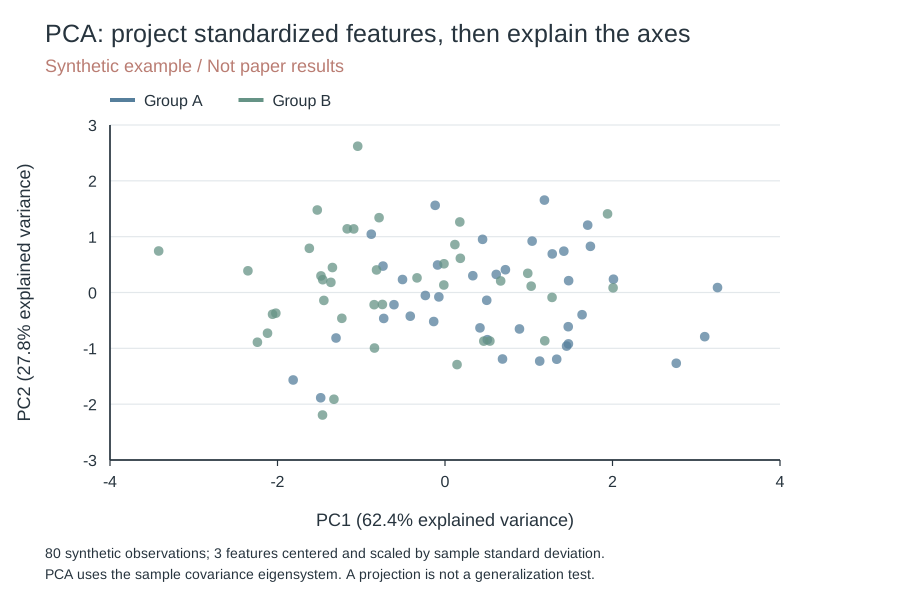
轴上写出计算得到的解释方差:PC1为62.4%,PC2为27.8%,避免只标抽象坐标。 颜色显示原分组,PCA未使用分组训练;投影分开不等于分类准确或泛化成立。 80个模拟样本、3个特征,先中心化并除以样本标准差,再由协方差矩阵求主成分。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
雷达与多指标(1 张)
雷达图:多指标逐轴读:每轴一个指标,写尺度、归一化和好坏方向;颜色再配点形。不同量纲不能用面积直接比较,轴顺序也会改变面积。
雷达图:多指标比较
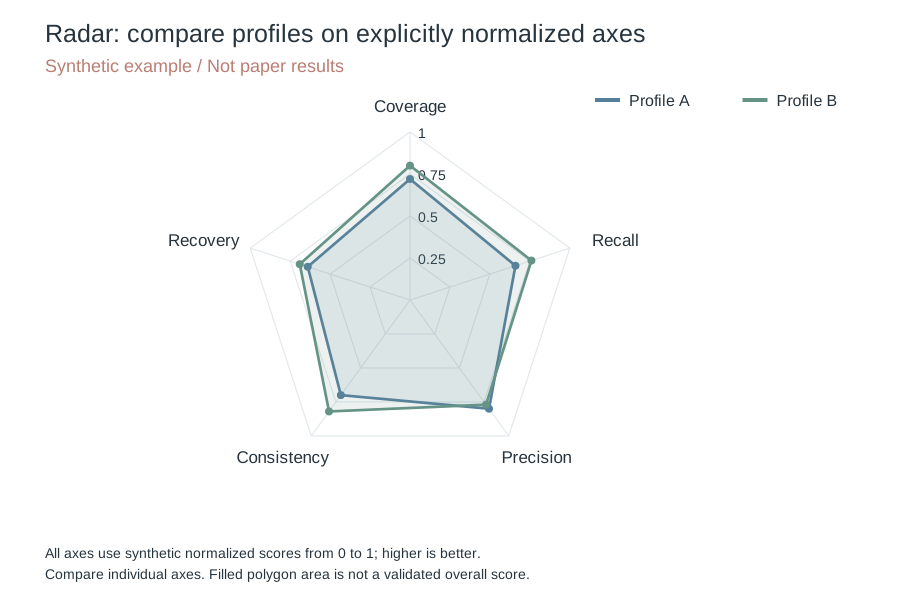
所有轴统一为0到1,方向统一为越高越好;真实图须先说明归一化方法。 同一组的点与线保持同色,逐轴比较各项表现。 图中未定义综合分数,多边形面积不能当作经过验证的总能力。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
置信带(1 张)
置信带:按实际重采样或模型计算区间,写清区间类型和置信水平。同一估计的嵌套区间才可比较覆盖范围;不同样本量、方差也会改变带宽。
置信区间与误差带
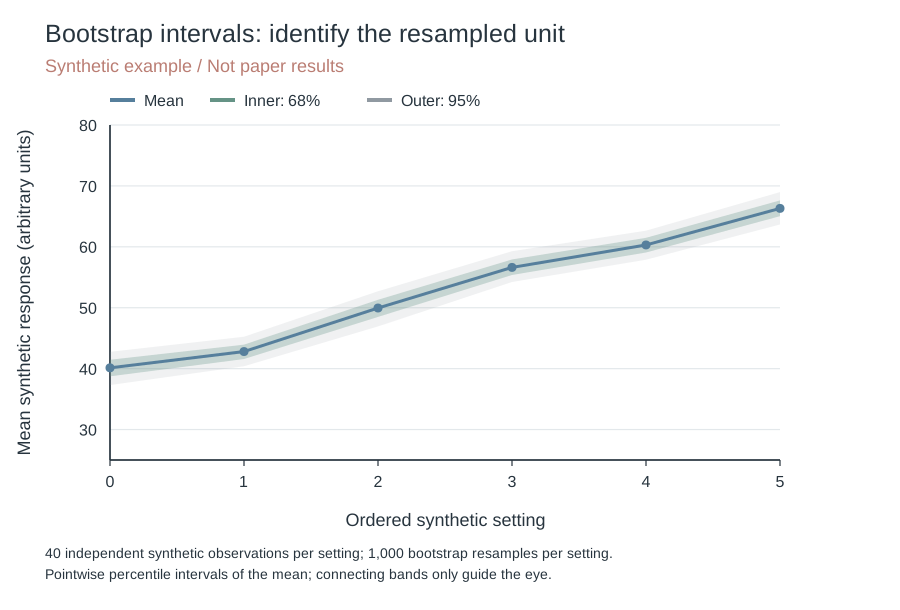
深线是模拟样本均值;内层为68%、外层为95%的逐点bootstrap区间,宽度来自计算。 每个设置有40个独立模拟观测,按观测有放回重采样1000次,再取均值分位数。 区间针对各个均值,不是整个函数的同时置信带,也不表示样本本身落在带内。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
配对增益(1 张)
配对增益:同一样本的干预与对照,画差值和零线;写清收益方向与尺度。
配对增益
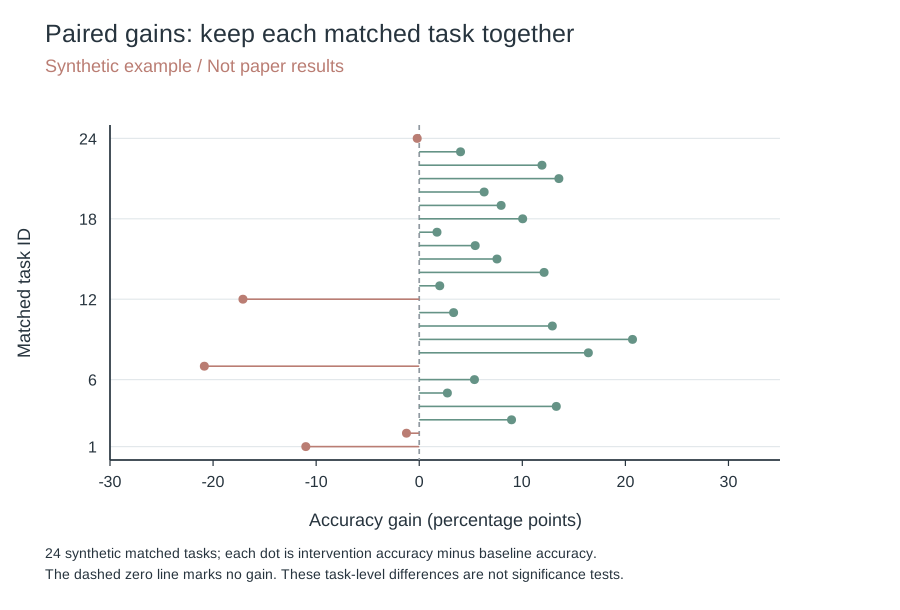
24个模拟任务各保留自己的配对关系;每点是同一任务的干预准确率减基线准确率。 零线右侧提高,左侧下降,收益与失败一起展示。 差值单位是百分点,不是相对百分比;任务散点没有进行显著性检验,也不能替代总体汇总。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
热图(1 张)
热图:条件乘方法,统一色标;正负增益以零为中点,缺测留空并说明。
热图:分组结果
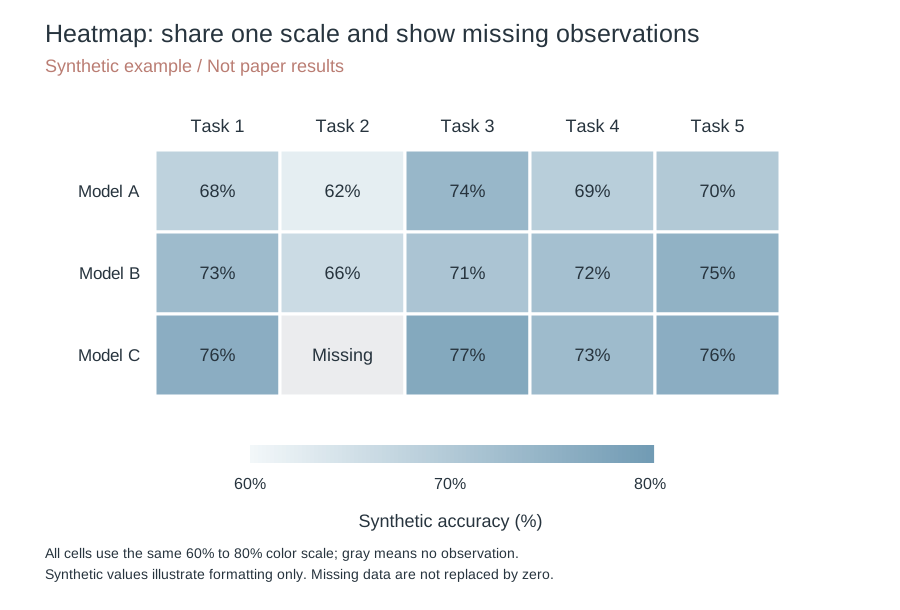
模型和任务交叉排列,格内直接标数值,让不辨色的读者也能比较。 全图使用60%到80%的同一色标;不能逐行归一化后继续横向比较颜色。 灰色只表示缺测,单独标Missing;缺测不能记为零分。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
成本性能图(1 张)
成本性能图:每点是一个实际配置;在线与离线成本分开,写单位和好坏方向。连接前沿不意味着有中间配置。
成本与性能
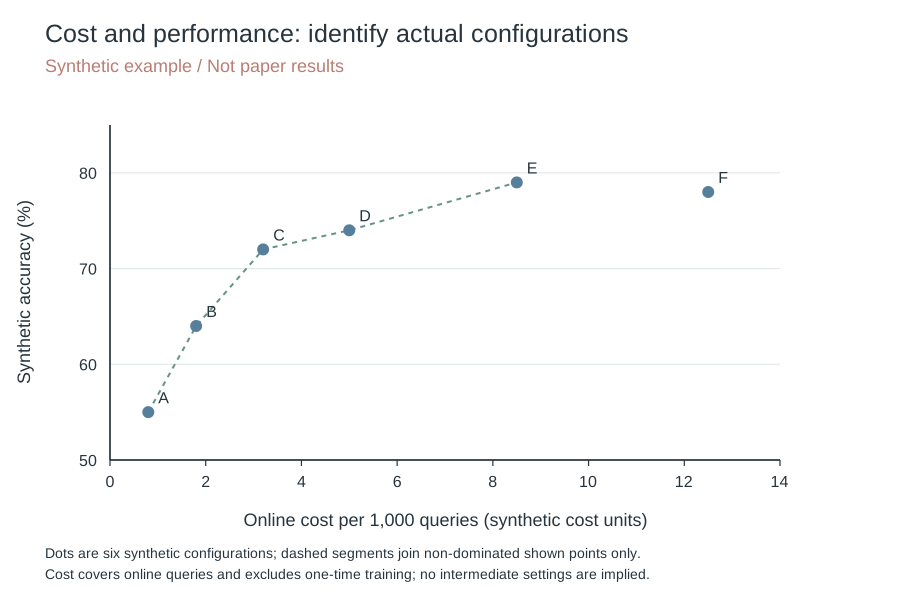
横轴按每1000次查询计模拟在线成本,纵轴是准确率;一次性训练成本须另行报告。 每个字母是一项明确的模拟配置,让成本与表现可以对应回具体设置。 虚线只连接已展示的非支配点,方便读取取舍;不证明中间配置存在,也不代表连续最优函数。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
饼图与环图(1 张)
数据集分布:先写清统计单位、样本量、类别与分母。同一图不能混用案例数、回复数与判据数;说明类别覆盖范围与占比。
饼图、环图与圆环排名:饼图只画互斥且组成整体的比例;圆环柱图可画排名,极值相邻只是环形排序,不是变量关系。要读精确差值,横向条图更方便。
环图:组成比例
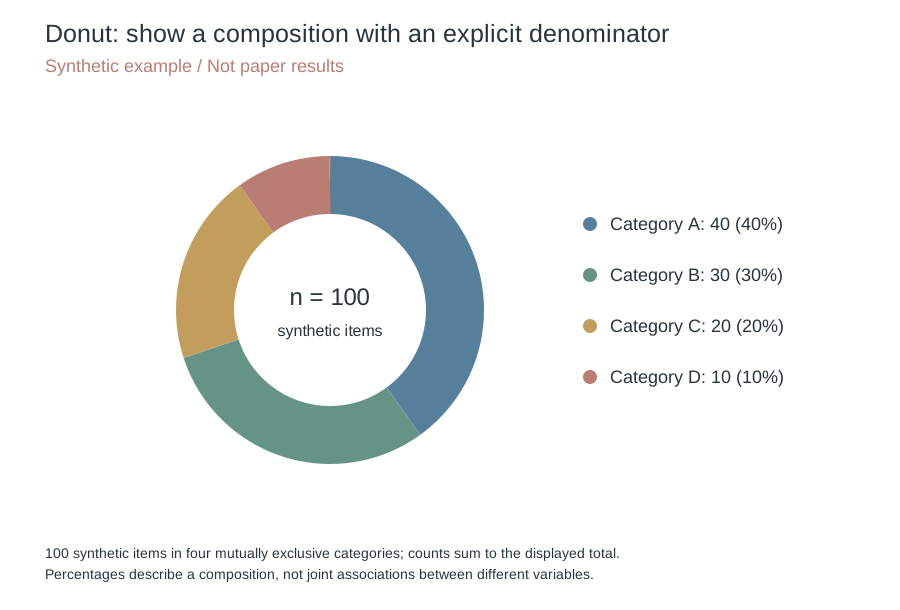
先写100个模拟对象,明确统计单位与分母,再看各类占比。 四类分别为40、30、20、10,总和为100;数量与比例同时列出,减少估读。 四类互斥,共同构成整体。精确比较相近比例时,数值或横向条图更直接。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
二维增益(1 张)
二维增益与九宫格:“可以用这种九宫格来分类,好处是可以看出两个渐进的变化” 两轴写指标、单位和好坏方向;差值图以零线分区,不为填满网格补造数据。
双指标增益
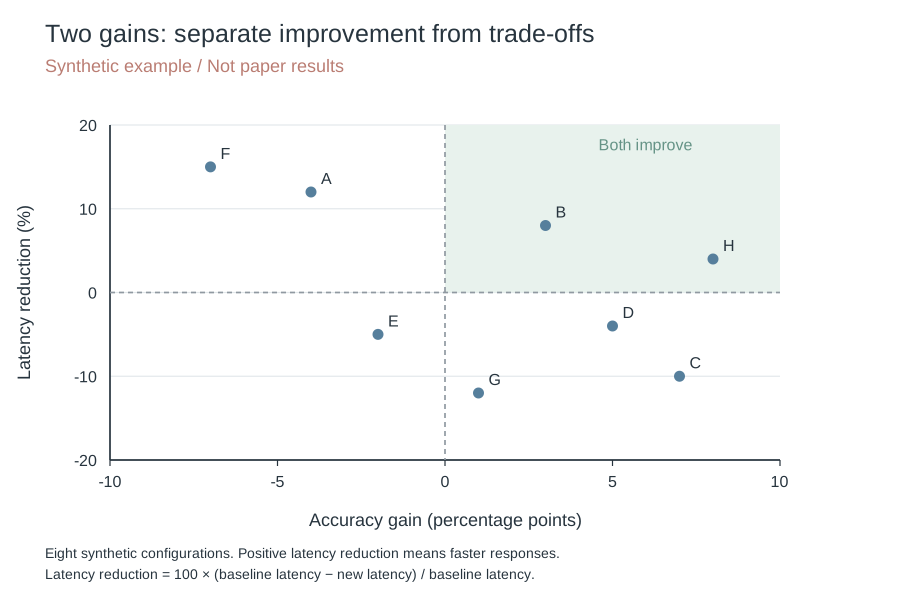
准确率增益向右更好,延迟减少向上更好;横轴用百分点,纵轴用相对百分比。 零线分出四个象限,右上表示两项同时改善,其余象限显示不同取舍。 每点是构造的模拟配置;象限只说明这两项指标的关系,不是论文结果或总体优越性的证明。
StarPaper 原创教学图 · 模拟数据,非论文结果 · CC BY 4.0
更多原图链接与点评
15-minute cities 图 1:地图、分布、多维散点:地图定位差异,累计分布看人口覆盖,散点把城市放到同一坐标系。横轴是人口加权平均邻近时间,纵轴是 15 分钟覆盖人口比例;颜色是 Gini,圆大小是人口密度。位置、颜色、大小各讲一件事。灰区是受概率约束的不可达组合,不是“平均不到 15 分钟就人人可达”。
适合“总体分布加个体差异”的多维呈现。四种编码有四种明确含义,再多就该拆图。
Bruno et al., A universal framework for inclusive 15-minute cities, Nature Cities (2024), DOI 10.1038/s44284-024-00119-4; arXiv:2408.03794v1
只链接原图,不重托管。arXiv 非独占分发许可。
15-minute cities 图 2:算法、排名、前后变化:先画人口导向的 POI 重分配,再给城市迁移比例排名,最后用罗马的地图和直方图看前后变化。POI 是服务设施点;(b) 排的是现有 POI 的迁移比例,不是新增设施数。
三个层次回答“怎么做、改动多大、改到了哪里”。排名负责总体差异,地图负责空间位置,直方图负责分布,谁也不用兼职。
Bruno et al., A universal framework for inclusive 15-minute cities, Nature Cities (2024), DOI 10.1038/s44284-024-00119-4; arXiv:2408.03794v1
只链接原图,不重托管。arXiv 非独占分发许可。
OneReason 图 12:对照策略的改动位置:相同结构对齐;改动位置突出,符号在图注解释。保留链接读图,不复制整图。
KDE:OneReason 图 6:四个领域并排,两个方法保持同色;淡填充保留重叠,虚线与均值标注把位置变化说清,曲线不用自己兼职字幕。
四个领域沿用同色方法与均值线。横轴是 Margin,纵轴是密度;不是累计概率。是否表示任务收益,另看原文对 Margin 的定义。
OneRec Team, OneReason Technical Report, arXiv:2606.06260v1, Fig. 6
只链接原图,不重托管。该版本采用 arXiv 非独占分发许可。
投影:life2vec 图 4,PaCMAP 与局部放大:中间给完整嵌入空间,两侧放大选定区域,同一批点分别按性别、年龄、真实标签着色;位置保持,颜色换问题。
原图明确使用 PaCMAP;保持点的位置、分别换属性颜色,才能追踪同一批点。投影和 TCAV 是不同证据,不能合成因果结论。
Savcisens et al., Nature Computational Science 4, 43–56 (2024), Fig. 4, DOI 10.1038/s43588-023-00573-5
只链接出版社图页;期刊版本未标明可转载的 CC 许可。
OneReason 图 1:把模型身份和结果放一起:左侧雷达看多任务表现,右侧成对柱图看推理和训练数据的作用;颜色、纹理、数值分工,提升与下降都直接标出。
雷达各轴的量纲与归一化必须定义,不能仅凭面积判断综合能力。 柱顶相对增幅与原分数同时保留;百分比不是百分点,下降项不能藏起来。
OneRec Team, OneReason Technical Report, arXiv:2606.06260v1, PDF p. 1
只链接原图,不重托管。该版本采用 arXiv 非独占分发许可。
OneReason 图 7:颜色跟着流程职责走:两边保持相同网络层次,只换雪花与火焰标记;第一阶段和后续阶段分别更新哪些参数,一眼能对上。
图标要有明确图例;颜色是辅助,不能只让读者猜蓝色是冻结。 同一层在两边位置一致,适合解释训练范围变化,不说明阶段间性能差异。
OneRec Team, OneReason Technical Report, arXiv:2606.06260v1, PDF p. 19
只链接原图,不重托管。该版本采用 arXiv 非独占分发许可。
OneReason 图 9:分布与多维特征分开读:左边堆叠条保留五档评分比例,右边雷达概括五项均分;先看分布,再看轮廓。
两面板使用同一组维度。雷达的数值标签便于准确读取,堆叠条显示不同评分构成;雷达面积不能替代具体分数。
OneRec Team, OneReason Technical Report, arXiv:2606.06260v1, PDF p. 29
只链接原图,不重托管。该版本采用 arXiv 非独占分发许可。
ShoppingBench 图 1、2:任务概览与案例层级:左边按请求、工具调用、观察和结果走流程,右边拆产品、优惠券和预算;高亮颜色贯穿两边,读者能把需求对到检查。 上面分产品采样和字段采样,下面把提示模板与生成指令逐行对齐;同一类任务同色,读者看得出结果从哪来。
背景、需求、动作、反馈分层;颜色和高亮有角色,不靠密集箭头补逻辑。
ShoppingBench: A Real-World Intent-Grounded Shopping Benchmark for LLM-based Agents, AAAI 2026, Fig. 1–2
只链接正式论文页,不重托管原图。
评论与批注
选中正文,可以高亮批注。
暂无评论。